

 12
 分享
引言Introduction
长读长测序能更完整地捕获结构变异,但流程搭建复杂,参数多,版本杂,结果还容易受分析代码影响。对医学生、医生和科研人员来说,最常见的痛点不是“没有数据”,而是没有一套可复现、可验证的SV分析流程 。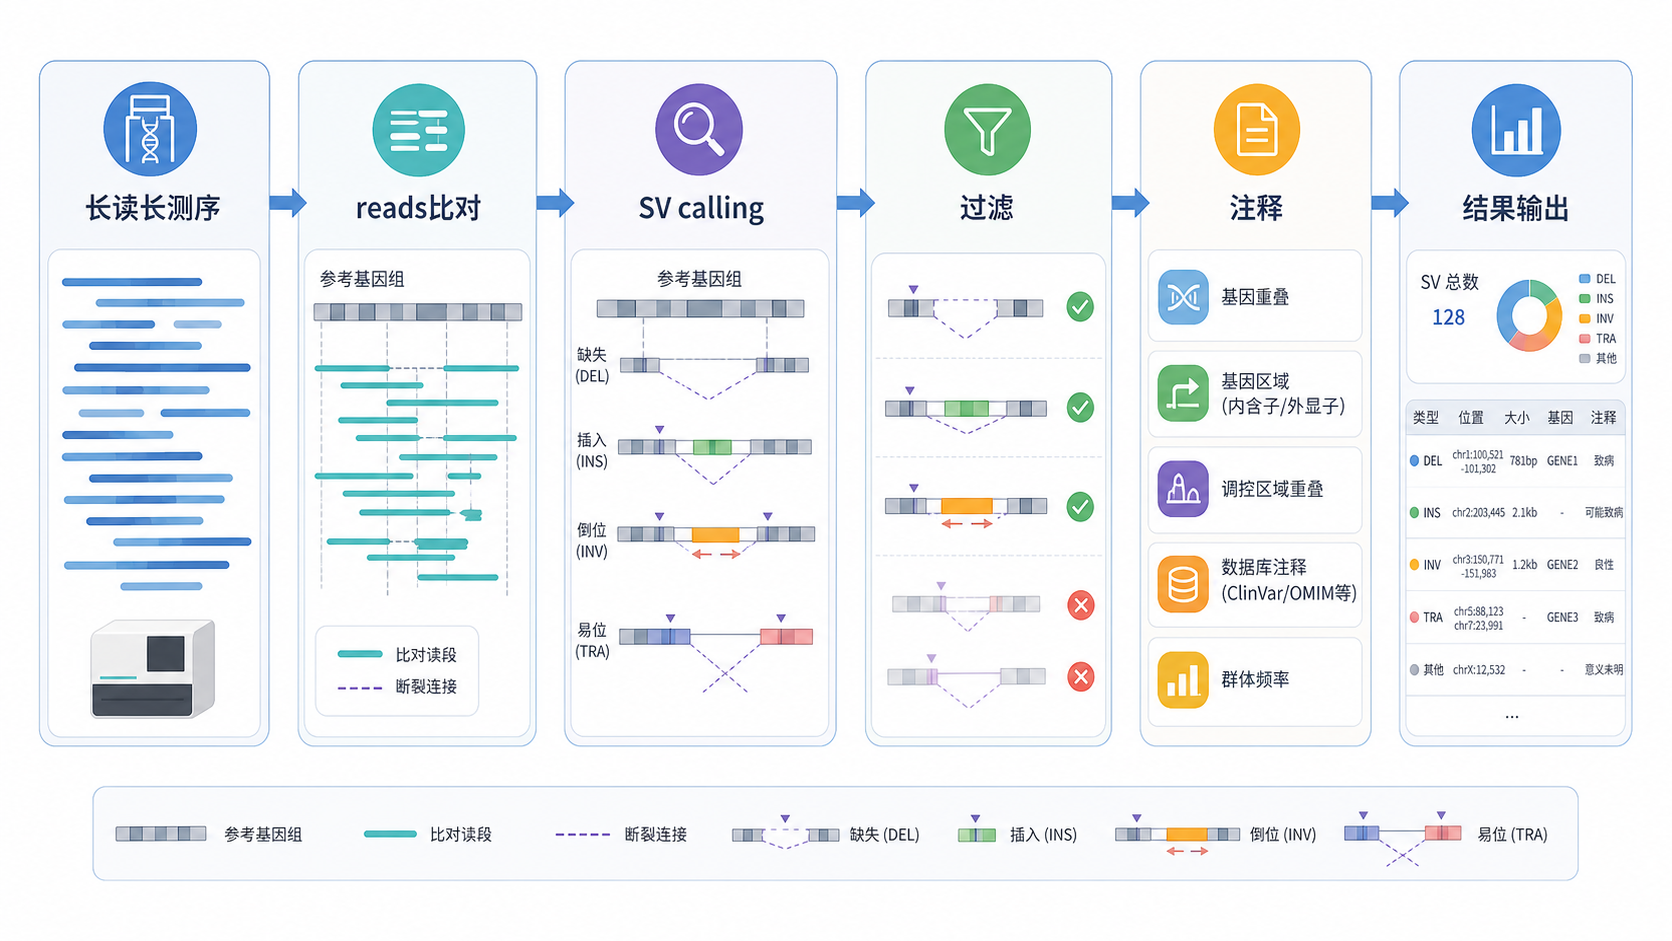
1. 长读长结构变异检测为什么更需要流程化
1.1 长读长SV分析的核心难点
长读长测序在插入缺失、倒位、易位和复杂重排的识别上更有优势,但真正落地时,问题集中在流程一致性。不同软件、不同参数、不同参考版本,都会影响最终结果。
结构变异检测不是单一软件输出,而是一条完整的分析链。 这条链包括比对、SV calling、过滤、注释和人工核查。任何一步偏差,都会放大到最终结论。
1.2 为什么不能依赖“现写代码”
上游知识库里已经说明,AI现写代码存在波动。即便同样任务执行两次,代码和文本都可能不一致。对懂代码的人来说,可以测试、修改、再验证。但对不熟悉代码的人来说,风险会明显增加。
在临床研究和生物医学分析中,流程的可重复性比“看起来能跑通”更重要。 因此,更合理的方式不是让模型临时生成一段脚本,而是让它调用固定工具和标准化流程。
1.3 适合长读长SV的分析逻辑
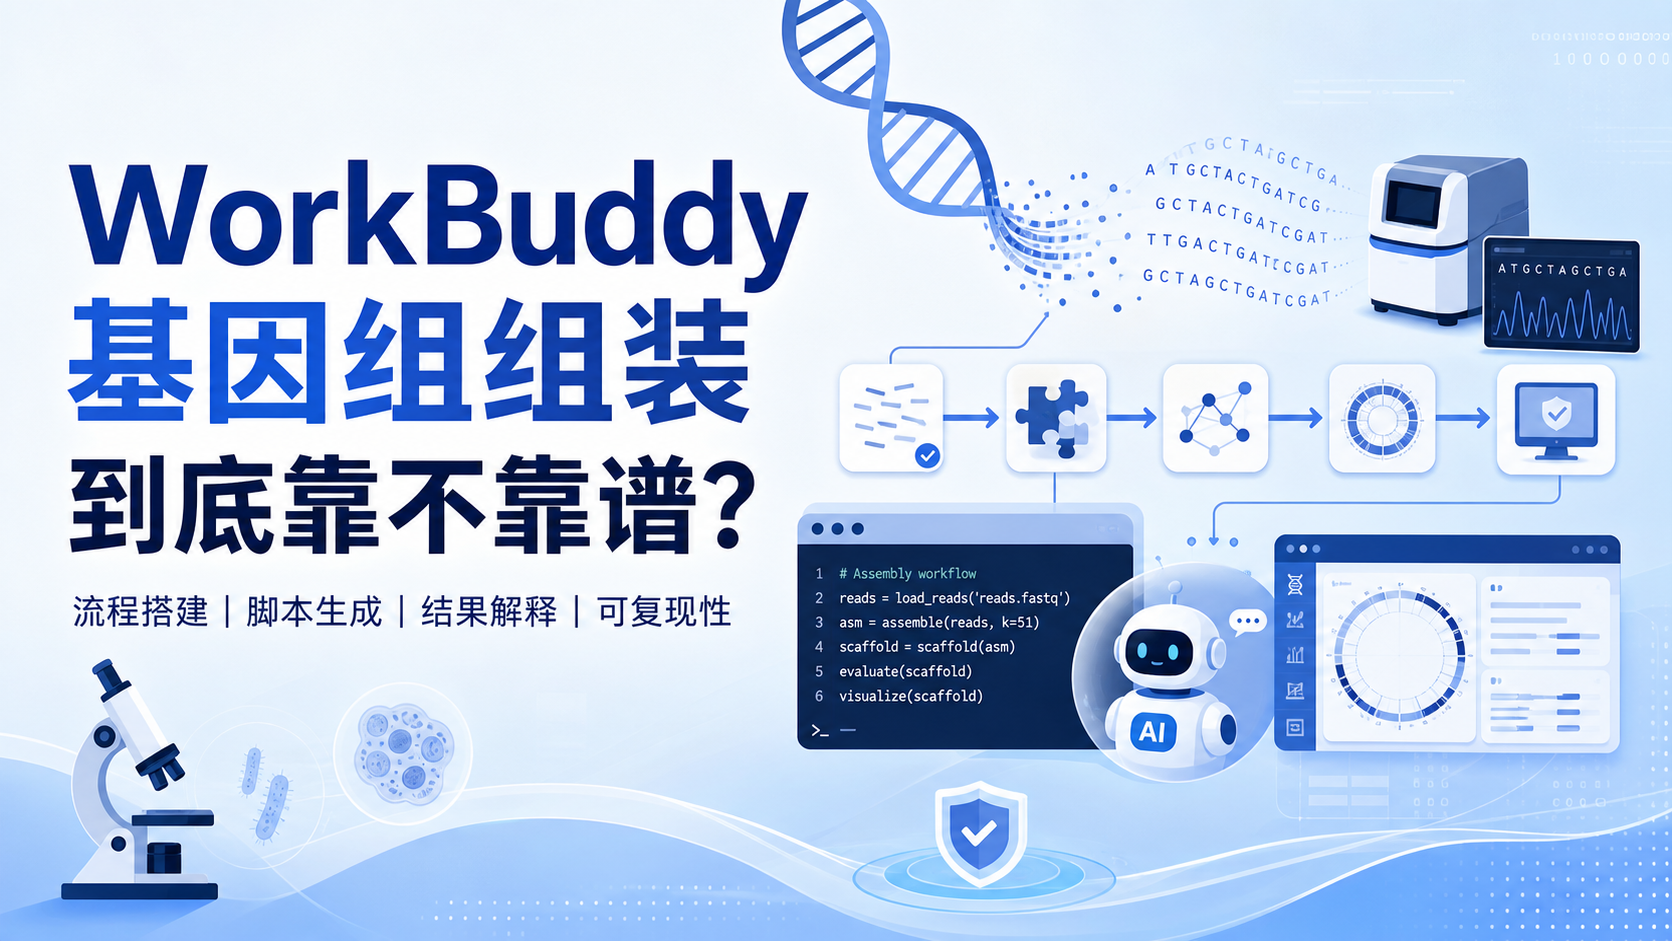
长读长SV流程的关键,不是追求“完全自动写代码”,而是把分析拆成可验证模块。常见思路包括:
- 读取原始测序数据。
- 完成高质量比对。
- 调用SV。
- 按质量和频率过滤。
- 做功能注释与候选优先级排序。
- 结合可视化和实验验证。
这种模块化流程更适合科研场景,也更利于复现和审稿。
2. 用WorkBuddy搭建长读长SV流程的思路
2.1 从“生成代码”转向“调用工具”
WorkBuddy在上游内容中被强调的优势,是可以通过配置和技能包来调用固定工具,而不是完全依赖AI临时现写代码。对于长读长SV流程,这一点很关键。
分析流程本质上是固定的,真正需要的是稳定地调用R包、脚本和工具链。
这比一次性生成代码更严谨,也更接近真实研究工作流。
2.2 适合拆分的流程模块
一个规范的长读长SV流程,可以拆成以下几个模块:
- 数据质控与格式整理。
- 长读长比对。
- SV检测。
- 结果合并与去冗余。
- 注释与功能筛选。
- 结果可视化与报告生成。
每个模块都应该有明确输入和输出。这样做的好处是,即使中间某一步需要修改,也不会破坏整条流程。
2.3 为什么技能包比临时问答更有价值
上游知识库提到,WorkBuddy正在把生物医学领域的技能包做成文档化流程参数,便于手动修改,也便于AI按指令调整。对SV流程来说,这种方式非常适用。
因为SV分析不是“聊天式任务”,而是有明确规范的计算流程。
例如,参考基因组版本、比对策略、SV caller选择、过滤阈值、注释数据库,都可以写入技能包。这样,后续换项目时,只需要调整配置,不必重新搭建整套逻辑。
3. 长读长SV流程中最关键的几个技术环节
3.1 比对是整个流程的基础
长读长数据的比对质量,直接影响后面的SV识别。若比对阶段存在大量错配或断裂,后续调用的结构变异会明显失真。
因此,流程设计时要先固定参考基因组版本,再固定比对工具和参数。
比对环节必须可复现,不能随意改动。
3.2 SV calling要强调工具稳定性
结构变异检测工具很多,但不同工具对插入、缺失、倒位和复杂重排的敏感性不同。实际项目中,通常需要结合研究目的选择工具,而不是盲目追求“最新”。
对于临床和科研场景,建议优先考虑:
- 工具是否适合长读长数据。
- 是否支持主流平台。
- 是否有稳定的社区支持。
- 是否便于版本锁定和结果复核。
流程化工具的价值,在于减少人为决策的波动。
3.3 结果过滤和注释决定可解释性
SV原始结果往往很多,但真正值得关注的只是少数高可信候选。这里必须做过滤和注释。
常见过滤维度包括:
- 支持读段数。
- 变异长度。
- 质量分数。
- 是否落在重复区域。
- 是否与已知病理位点相关。
注释阶段则要结合基因区域、转录本影响、疾病数据库和文献证据。没有注释的SV,只是一串坐标;经过注释后,才有生物学意义。
4. WorkBuddy在实际应用中的优势与边界
4.1 优势是流程标准化,不是“替代专业判断”
上游知识库中提到,模型可以帮助生成研究方案、分析路线和实验链,但最终结果仍需人工润色和校验。这个原则同样适用于长读长SV流程。
WorkBuddy更适合做三件事:
- 把流程拆清楚。
- 把工具链固定下来。
- 把参数和步骤记录下来。
它不是替代生信分析师,而是降低重复劳动和流程混乱。
4.2 对新手和非代码用户更友好
如果研究者不熟悉代码,最容易出现的问题是:流程能跑,但不知道结果是否可靠。
WorkBuddy的价值在于把复杂工作流做成可配置结构。用户只需根据研究目标调整配置文件,而不是从零改写脚本。
这对临床科研团队尤其重要,因为很多项目需要快速启动,但团队里未必人人都能熟练维护代码。
4.3 仍然需要人工校验
必须强调,任何自动化流程都不能替代结果复核。
长读长SV流程中,建议至少保留以下人工检查:
- 比对结果抽查。
- 关键SV位点可视化核对。
- 重点候选与样本表型的一致性判断。
- 最终报告的医学语境审读。
这也是E-E-A-T原则在生物医学内容中的核心体现。结论必须建立在可验证证据上,而不是模型自信输出。
5. 一个更实用的搭建路径
5.1 先固定流程框架,再做个性化调整
搭建长读长SV流程时,建议按以下顺序推进:
- 明确研究问题,是肿瘤SV、遗传病SV,还是群体研究。
- 固定参考基因组和注释版本。
- 选择适配长读长数据的比对和SV检测工具。
- 设定过滤标准和输出格式。
- 补充可视化和报告模板。
先标准化,再优化。不要一开始就追求最复杂的自动化。
5.2 用配置文件管理可变部分
上游知识库提到,客户端换一个,只需要把配置文件拷过去。这一点很适合流程工程化。
对长读长SV流程来说,可变部分通常包括:
- 样本信息。
- 测序平台。
- 参考基因组。
- 过滤阈值。
- 输出目录。
把这些内容从代码中拆出来,流程就更容易迁移,也更容易复用。
5.3 让结果服务于临床和科研目标
长读长SV检测的最终目标,不是“跑出一堆文件”,而是服务于问题。
在肿瘤研究中,它可能帮助识别驱动基因重排。
在遗传病研究中,它可能帮助发现致病缺失或复杂重排。
在队列研究中,它可以支持群体差异分析和预后建模。
流程越清晰,结果越容易进入论文、标书和临床解释。
总结Conclusion
长读长结构变异检测的难点,不在于有没有工具,而在于能否建立一套稳定、可复现、可校验 的流程。WorkBuddy的价值,正是把分析从“临时写代码”推进到“固定工具链和技能包驱动的标准化流程”。对于医学生、医生和科研人员来说,这能显著降低入门门槛,也能减少分析偏差。
如果你正在搭建长读长SV流程,建议从配置化、模块化、可验证三个方向入手。想更快把项目落地,可以借助解螺旋 的工具与内容支持,先把流程框架搭稳,再做个性化优化。
- 引言Introduction
- 1. 长读长结构变异检测为什么更需要流程化
- 2. 用WorkBuddy搭建长读长SV流程的思路
- 3. 长读长SV流程中最关键的几个技术环节
- 4. WorkBuddy在实际应用中的优势与边界
- 5. 一个更实用的搭建路径
- 总结Conclusion