

 22
 分享
引言Introduction
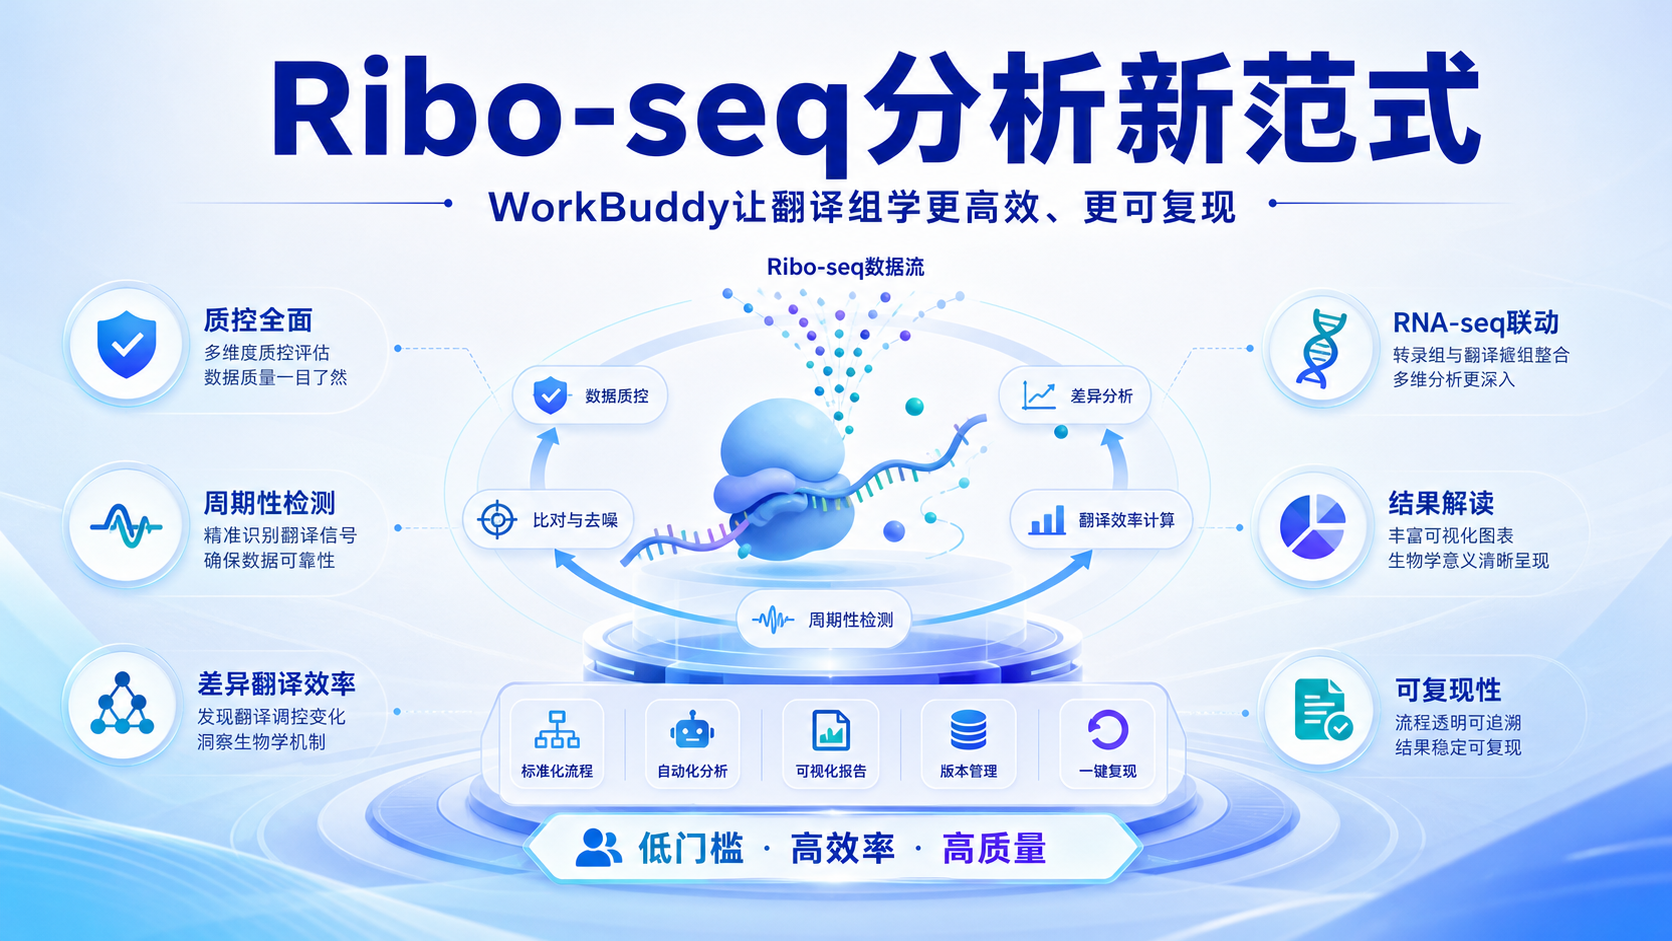
Ribo-seq数据分析链条长、步骤多,容易卡在质控、比对、周期性判断和差异翻译效率计算。对医学生、医生和科研人员来说,真正的难点不是“能不能跑”,而是“能否快速、规范、可复现地跑完并解释结果”。
1. Ribo-seq为何需要新的分析范式
1.1 翻译组学的价值,不止是看表达量
Ribo-seq,也叫核糖体测序,研究的是正在被核糖体翻译的mRNA片段 。它和RNA-seq不同。RNA-seq回答“转录了多少”,Ribo-seq回答“真正被翻译了多少”。
这也是它在机制研究中的价值所在。尤其在肿瘤、免疫、代谢和应激反应研究中,很多关键变化并不发生在转录层面,而发生在翻译层面。如果只看RNA-seq,容易漏掉翻译调控这一层信息。
1.2 传统流程的痛点很明确
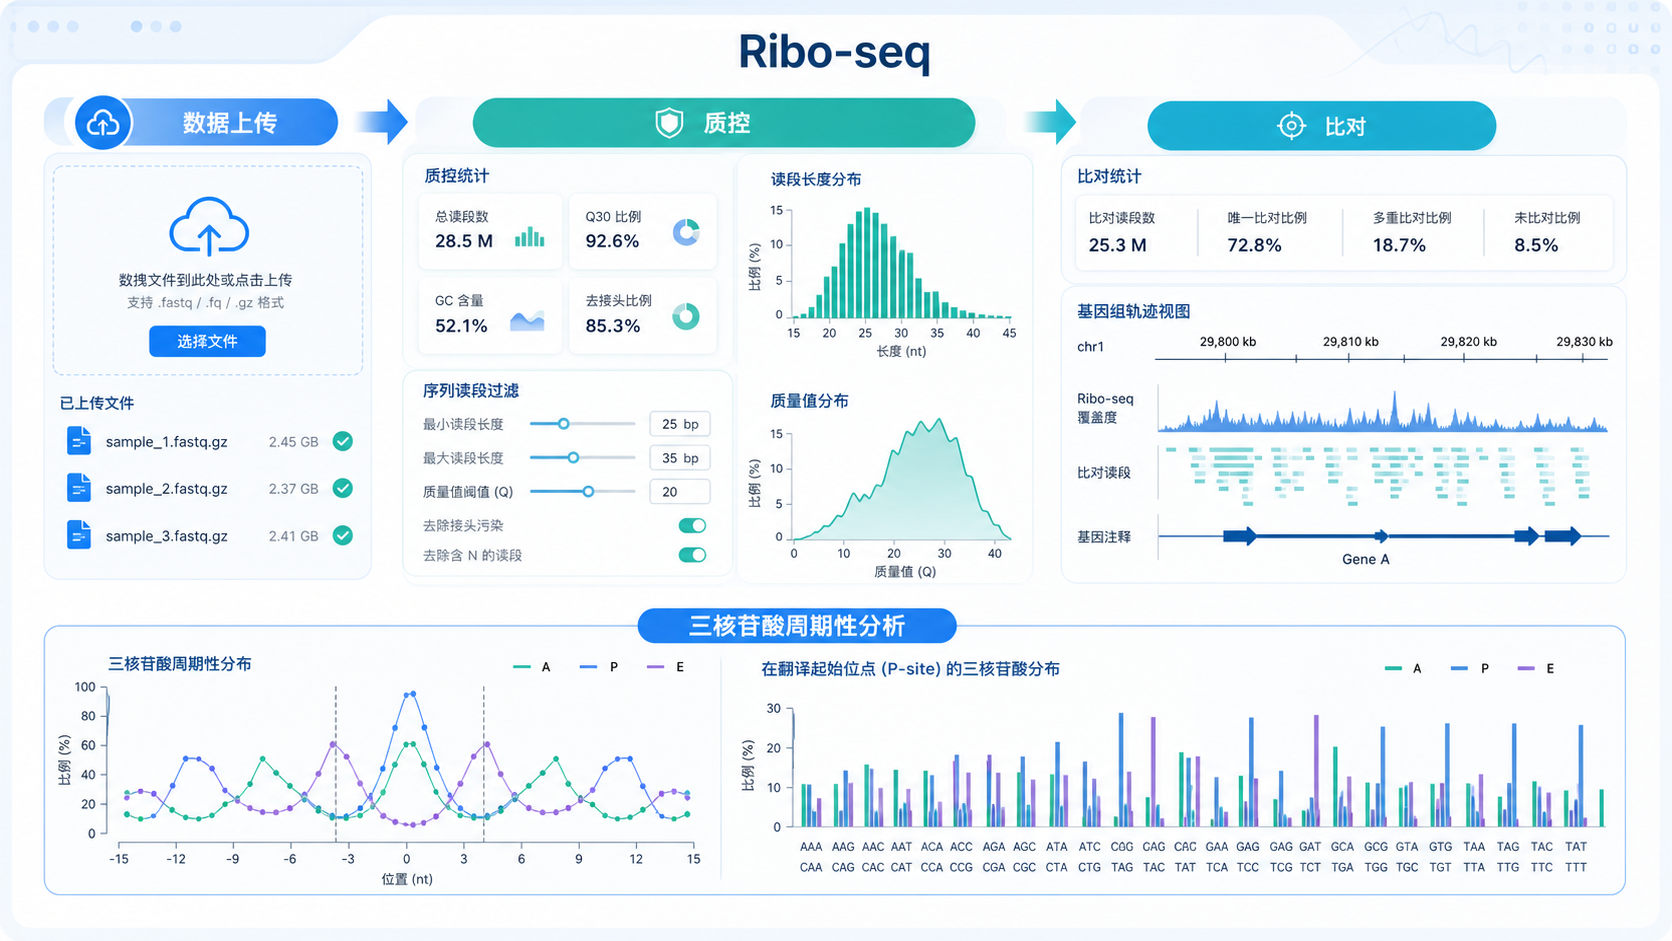
Ribo-seq分析通常涉及多个环节:
- 原始数据质控。
- 接头去除和rRNA污染过滤。
- 比对到参考基因组或转录组。
- 读取长度分布分析。
- 三核苷酸周期性检查。
- 开放阅读框识别。
- 翻译效率和差异翻译分析。
每一步都可能出错。格式错了,结果就不可信。参数不一致,复现就会失败。对于缺少生信基础的实验人员,这条链路的门槛很高。
1.3 新范式的核心,不是“多做一步”,而是“减少摩擦”
真正高效的Ribo-seq分析平台,应该把“上传、校验、运行、出图、解释”串起来。
重点不只是自动化,而是:
- 减少手工拼接步骤。
- 降低格式和参数错误率。
- 保留可追溯的分析记录。
- 让结果更容易进入论文、汇报和课题设计。
这正是WorkBuddy这类AI工作流工具的价值点。它不是替代研究者,而是把复杂流程标准化、模块化。
2. WorkBuddy如何重构Ribo-seq分析流程
2.1 从“工具堆叠”变成“流程驱动”
传统Ribo-seq分析往往依赖多个软件、脚本和中间文件。研究者需要自己决定先做什么、后做什么、每一步输出如何衔接。
WorkBuddy的优势在于把分析任务组织成可执行的工作流。 你不必从零拼接每个环节,而是根据任务目标选择对应模块。
这对教学、课题组协作和临床科研尤其重要。因为同一套流程可以被不同成员重复使用,减少“只有一个人会跑”的风险。
2.2 让数据验证先于计算开始
Ribo-seq最常见的问题之一,是数据格式不规范。比如样本信息缺失、注释版本不一致、输入文件命名混乱。
如果这些问题拖到分析后期才发现,前面所有计算都可能作废。
WorkBuddy的流程化设计,核心价值之一就是前置校验。
也就是说,先检查输入是否符合要求,再进入正式计算。这种机制能明显降低无效计算的概率,也更适合科研场景中的标准化管理。
2.3 把复杂步骤变成可解释的阶段结果
Ribo-seq不是单一统计检验,而是一系列层层递进的分析。
好的流程平台,应该能让用户在每个阶段看到明确输出,例如:
- 读取长度分布是否合理。
- 三核苷酸周期性是否成立。
- 翻译活跃区域是否清晰。
- 差异翻译基因是否稳定。
- 结果能否支持后续机制假设。
这类“阶段可见”的设计,能显著提高结果可信度。 研究者不再只拿到一个终点表格,而是拿到一条可解释的证据链。
3. Ribo-seq分析中最关键的技术环节
3.1 质控和周期性,是Ribo-seq成败的门槛
Ribo-seq最核心的特征之一,就是核糖体保护片段具有长度偏好,并呈现明显的三核苷酸周期性。
如果这两个特征不成立,后续翻译分析的解释力会大幅下降。
因此,分析时必须重点检查:
- 片段长度是否集中。
- 是否存在明显rRNA污染。
- 比对是否落在预期编码区。
- 周期性是否清晰。
这不是形式化步骤,而是判断数据能不能进入下游分析的关键依据。
3.2 差异翻译效率分析,要和RNA-seq联动
Ribo-seq单独看只能说明翻译信号。真正有机制意义的,是把它和RNA-seq联合起来,计算翻译效率变化。
常见问题包括:
- mRNA上升,但翻译不变。
- mRNA不变,但翻译明显增强。
- 转录和翻译方向相反。
这些情形往往比单纯差异表达更接近生物学本质。
所以,Ribo-seq的重点不是“找多少基因变化”,而是“找到哪些变化发生在翻译层面”。
3.3 结果解读要回到问题本身
Ribo-seq分析的终点,不应该只是图和表。
它需要回答研究问题,比如:
- 某个刺激是否改变整体翻译活性。
- 某条通路是否在翻译层面被重编程。
- 某个基因的上调是否来自翻译增强。
- 某种药物是否通过抑制核糖体装载发挥作用。
只有回到生物学问题,Ribo-seq结果才有论文价值。
4. WorkBuddy在Ribo-seq场景中的实际优势
4.1 更适合非生信背景的研究者
很多临床科研团队并不缺样本,也不缺问题,缺的是稳定可用的分析能力。
Ribo-seq恰好是一个对计算要求较高的场景。WorkBuddy的价值就在于,它能把复杂流程变成更接近“任务提交”的模式。
这对以下人群尤其有帮助:
- 需要快速验证机制的博士和博后。
- 想把组学数据纳入课题设计的临床医生。
- 需要统一分析规范的实验室团队。
4.2 适合做方法复现和课题预分析
Ribo-seq分析常用于方法验证、课题预研和论文复现。
在这些场景里,研究者最需要的是效率和一致性,而不是反复搭建环境。
WorkBuddy这类平台的优势在于:
- 流程固定,减少人为波动。
- 步骤清晰,便于组内共享。
- 输出标准化,便于整理成报告。
- 适合做多批次、多个样本的统一处理。
对于需要在有限时间内完成课题推进的人来说,这种效率优势非常实际。
4.3 让结果更容易进入论文写作
Ribo-seq的下游结果通常要服务于论文图表、机制图和补充材料。
如果分析平台能直接给出规范结果,研究者就能更快进入写作阶段。
常见可直接用于论文的内容包括:
- 周期性和长度分布图。
- 差异翻译基因列表。
- 富集分析结果。
- 翻译效率变化图。
- 关键基因的可视化展示。
从分析到写作的距离越短,科研推进速度就越快。
5. 为什么说这是翻译组学分析新范式
5.1 新范式强调“可复现”
翻译组学研究越来越强调标准化。因为Ribo-seq很容易受实验条件、建库方式和参数设置影响。
如果分析流程不固定,结果就很难比较。
WorkBuddy代表的思路,是把分析过程结构化。
可复现不是附加项,而是翻译组学走向成熟的前提。
5.2 新范式强调“低门槛高质量”
一个好的系统,不是让少数人跑得更快,而是让更多人跑得对。
这正是Ribo-seq分析当前最需要的改变。
对于医学生、医生和科研人员来说,理想的分析平台应该满足:
- 不需要大量命令行操作。
- 不需要频繁切换工具。
- 不需要手动拼接复杂脚本。
- 结果能被快速解释和复核。
当门槛降低,翻译组学才真正进入广泛应用阶段。
5.3 新范式强调“从结果到假设”
Ribo-seq不是终点。它更像一个假设生成工具。
高质量流程能帮助研究者从数据中快速提炼出下一步问题,例如:
- 哪些基因存在翻译层面的异常。
- 哪些通路可能是干预靶点。
- 哪些现象值得进一步做机制实验。
这也是WorkBuddy类平台的长远意义。它不只是跑流程,更是在帮助研究者把数据转化为研究思路。
总结Conclusion
Ribo-seq的价值在于揭示翻译层面的真实生物学变化,但其分析流程长、门槛高、复现难。WorkBuddy+Ribo-seq的组合,代表了一种更标准化、更高效、更适合科研协作的翻译组学分析方式。
如果你正在做Ribo-seq,或准备把翻译组学纳入课题设计,建议优先考虑能够提升流程稳定性和结果可解释性的工具。想把复杂分析变成可执行、可复现、可写入论文的结果,可以关注解螺旋,借助其产品和工作流思路,更高效地推进你的组学研究。
- 引言Introduction
- 1. Ribo-seq为何需要新的分析范式
- 2. WorkBuddy如何重构Ribo-seq分析流程
- 3. Ribo-seq分析中最关键的技术环节
- 4. WorkBuddy在Ribo-seq场景中的实际优势
- 5. 为什么说这是翻译组学分析新范式
- 总结Conclusion