35
 分享
引言Introduction
预后因素分析不是简单做几个统计检验。真正的难点在于,如何从一堆变量中找出与结局相关的因素,再把结果转成可用于临床决策的模型。如果只会做单因素分析,却不会建模、验证和解释,研究很难落地。 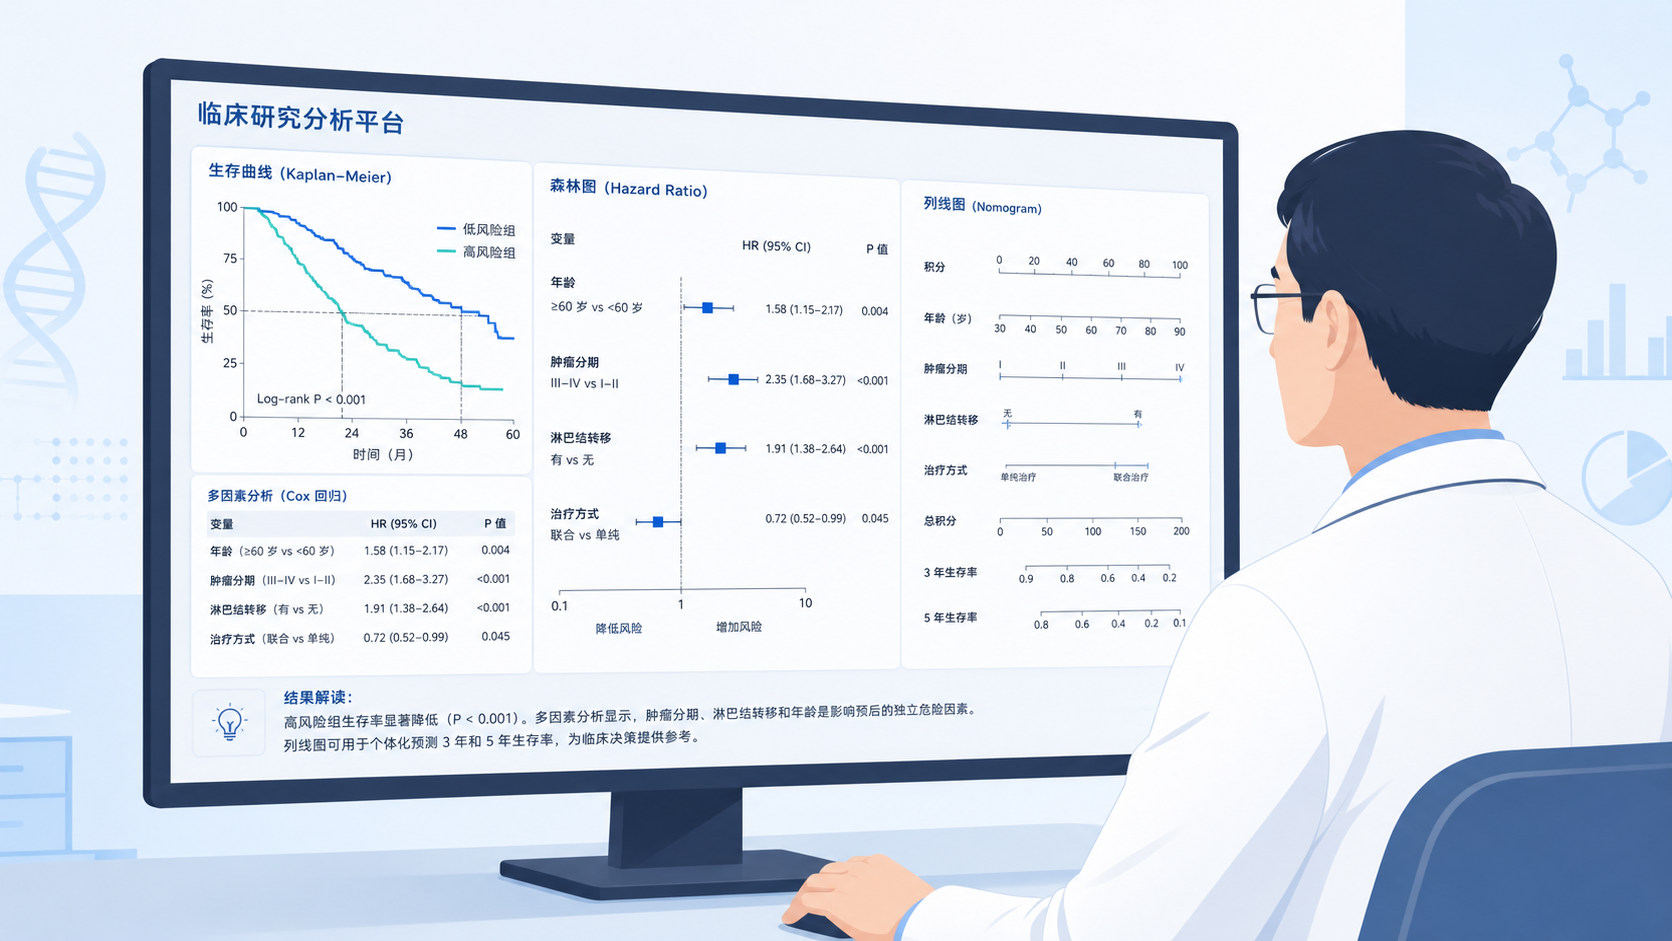
1. 预后因素分析的核心目标
1.1 从“相关”走向“可预测”
预后因素分析的第一步,是回答一个明确的问题。某个变量,是否与结局有关。比如全因死亡、复发、生存时间,或其他临床终点。这个阶段常见的是单因素分析。它的作用不是定论,而是筛选候选变量。
单因素分析的价值,在于快速识别“可能有用”的变量。 但它有明显局限。它没有控制混杂因素,所以结果只能说明表面关联,不能直接解释因果关系。
1.2 为什么要进入多因素分析
临床数据通常不是单变量决定结局。年龄、分期、实验室指标、治疗方式,往往彼此交织。多因素分析的意义,就是在控制其他变量后,判断某个因素是否仍然独立相关。
对于预后研究,这一步非常关键。因为只有独立相关因素,才更适合进入后续模型构建。也就是说,多因素分析不是重复单因素,而是在更接近真实临床场景下做筛选。
2. 单因素分析怎么做才规范
2.1 先明确结局,再处理变量
做预后因素分析前,必须先定义结局。是OS,PFS,还是复发?不同结局对应不同模型。结局变量定不清,后面的统计再漂亮也没有意义。
自变量则要提前整理。连续变量保留原始信息更好,分类变量要统一编码。若变量过多,建议先做描述性统计,再决定是否分组。不要为了图方便,随意把连续变量粗暴二分。 这会损失信息,也可能降低统计效能。
2.2 单因素结果怎么看
单因素分析常用 Cox 回归或 Logistic 回归。具体选择取决于结局类型。
常见输出包括:
- HR 或 OR
- 95%置信区间
- P值
判断标准很直接。P值提示统计学显著性,HR或OR提示效应方向和大小。但要注意,P值小不等于临床价值高。 有些变量虽然显著,但效应量很小,实际意义有限。
2.3 单因素结果如何进入下一步
一般来说,单因素分析后会筛出候选变量进入多因素模型。常用做法是结合统计学结果和临床意义综合判断,而不是机械照搬P<0.05。
推荐遵循两条原则:
- 有明确临床意义的变量,即使P值边缘,也可保留。
- 变量数要与样本量匹配,避免模型过拟合。
预后因素分析不是变量越多越好,而是模型越稳越好。
3. 多因素分析:识别独立预后因素
3.1 混杂因素必须控制
多因素分析的核心,是控制混杂。比如某个治疗方式看起来与生存相关,但实际可能是因为分期不同导致的。若不调整分期,这个结论就不稳。
因此,在建模时要清楚区分:
- 暴露因素
- 结局变量
- 混杂因素
- 可能的交互因素
如果混杂因素没有处理好,后续列线图的临床可信度会明显下降。
3.2 模型拟合的基本要求
无论是 Cox 还是 Logistic,模型都需要满足基本统计前提。包括变量编码合理、样本量足够、共线性不过强。若变量之间高度相关,回归系数会不稳定,甚至导致方向反转。
实践中建议:
- 检查变量相关性
- 评估多重共线性
- 控制进入模型的变量数量
- 保持模型简洁
一个过度复杂的模型,往往比一个简洁模型更难推广。
3.3 输出结果如何解读
多因素分析的重点,不是“谁显著”,而是“谁仍然独立显著”。这类变量才是后续列线图的核心候选项。
例如,模型中如果年龄、分期、某实验室指标仍然显著,就说明它们在控制其他因素后仍与结局相关。这样的结果更适合进入预测模型,而不是停留在论文表格里。
4. 从回归结果到列线图模型
4.1 列线图为什么适合临床
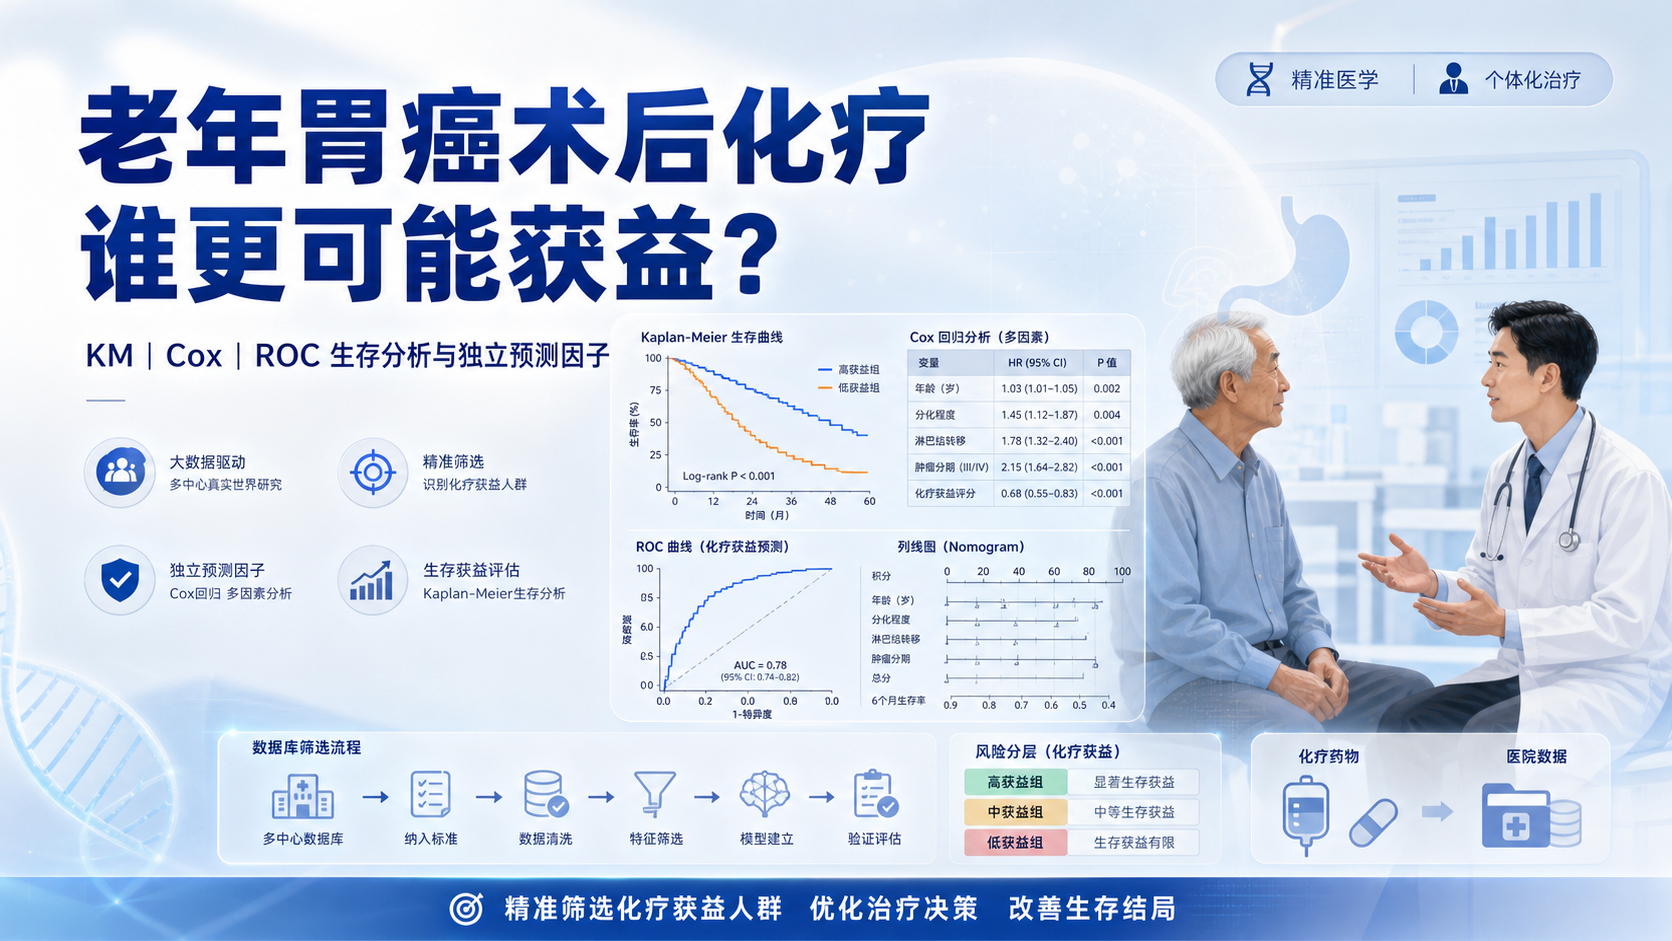
列线图的优势是直观。它把回归方程转成图形,把抽象的统计结果转成可操作的临床工具。临床医生可以根据每个变量的分值,快速估计患者的风险。
列线图的本质,是把“多个预后因素”整合成一个可视化预测系统。 它适合展示个体化风险,也更容易被临床接受。
4.2 列线图的结构怎么理解
列线图通常包含三部分:
- 每个变量的评分轴。
- 总分轴。
- 结局概率轴。
变量对结局贡献越大,轴线通常越长,权重也越高。最终通过总分映射到结局概率。对于医学生和科研人员来说,理解这一步很重要,因为它决定了模型不是“看起来复杂”,而是“可以被临床使用”。
4.3 列线图建立的前提
列线图不是单独生成的,它建立在稳定的多因素模型上。也就是说,先有回归分析,再有列线图。顺序不能反。
如果模型本身不稳定,列线图只是把不稳定结果图形化,价值有限。所以列线图的前提,不是漂亮,而是准确。
5. 模型评价:决定能不能用
5.1 区分度,先看模型能不能分开人群
区分度常用 ROC 或 time-dependent ROC 评价。它回答的是一个问题,模型能否把高风险和低风险患者区分开。AUC 越高,区分能力通常越好。
在预后模型中,区分度是最基础的门槛。 如果模型连“谁更危险”都分不清,临床价值就很有限。
5.2 校准度,看预测和现实是否一致
校准曲线用于比较预测值和实际值。理想情况下,曲线应尽量贴近45度线。它反映的是模型预测概率是否可靠。
很多研究只重视AUC,却忽略校准。实际上,一个AUC不错但校准差的模型,临床上仍然不够可信。 因为它预测的概率不准,医生难以据此决策。
5.3 临床净获益,判断是否值得使用
DCA,即决策曲线分析,关注的是临床获益。它解决的不是“模型准不准”,而是“用了之后值不值”。这一步很重要,因为预测模型最终要服务于干预决策。
DCA中,模型曲线如果明显优于“全部干预”或“全部不干预”,说明模型可能带来更好的净获益。这也是预后因素分析走向临床转化的关键一步。
6. 结果展示与论文写作要点
6.1 单因素和多因素森林图
森林图是预后因素分析中最常见的结果展示方式之一。它能把HR、95%CI和P值清晰展示出来,适合论文正文和补充材料。
绘图前要整理好数据格式。通常需要包含:
- 变量名
- HR或OR
- 95%CI上下限
- P值
图形要简洁。不要堆太多无关信息。清晰的森林图,比复杂但难读的图更有发表价值。
6.2 文字描述要客观
写作时不要夸大结论。建议用规范表达方式:
- 单因素分析中,某变量与结局显著相关。
- 多因素分析中,某变量仍为独立预后因素。
- 列线图在训练集和验证集中表现稳定。
这样的表达更符合科研规范,也更容易通过审稿。
7. 让预后因素分析真正落地
7.1 训练集之外,还要做验证
一个模型能否推广,不能只看训练集。还要做内部验证或外部验证。前者评估稳定性,后者评估泛化能力。没有验证的模型,通常只能算初步结果。
7.2 研究设计要前后一致
从单因素到多因素,再到列线图,逻辑必须连贯。结局定义一致,变量编码一致,统计方法一致。这样才能保证结果可信。
预后因素分析的最终目标,不是做出一张图,而是做出一个能帮助临床判断风险的工具。
7.3 借助规范工具提升效率
如果你希望把单因素分析、多因素建模、列线图绘制和模型验证做得更规范,建议借助成熟的平台和流程工具。解螺旋 可以帮助你把研究思路、统计流程和结果呈现串起来,减少重复试错,让预后因素分析更高效、更接近发表标准。
总结Conclusion
预后因素分析的标准流程,是从单因素筛选开始,经多因素分析识别独立因素,再进一步构建列线图模型,并用区分度、校准度和DCA评价模型价值。真正有临床意义的,不只是显著变量,而是经过验证、可解释、可落地的预测工具。
如果你正在做预后研究,建议把重点放在变量选择、混杂控制、模型验证和结果呈现上。这样才能让研究从“统计结果”走向“临床工具”。想要进一步提升预后模型构建效率和规范性,可以关注解螺旋 ,把复杂流程做得更清晰、更专业。

- 引言Introduction
- 1. 预后因素分析的核心目标
- 2. 单因素分析怎么做才规范
- 3. 多因素分析:识别独立预后因素
- 4. 从回归结果到列线图模型
- 5. 模型评价:决定能不能用
- 6. 结果展示与论文写作要点
- 7. 让预后因素分析真正落地
- 总结Conclusion