21
 分享
引言Introduction
ROC曲线是生信文章里最常见的评估图之一,但很多人只会“画图”,不会“解释图”。真正的难点在于,如何从原始数据开始,正确完成分组、预测、AUC计算,再把ROC和其他结果整合成可发表的复合图。
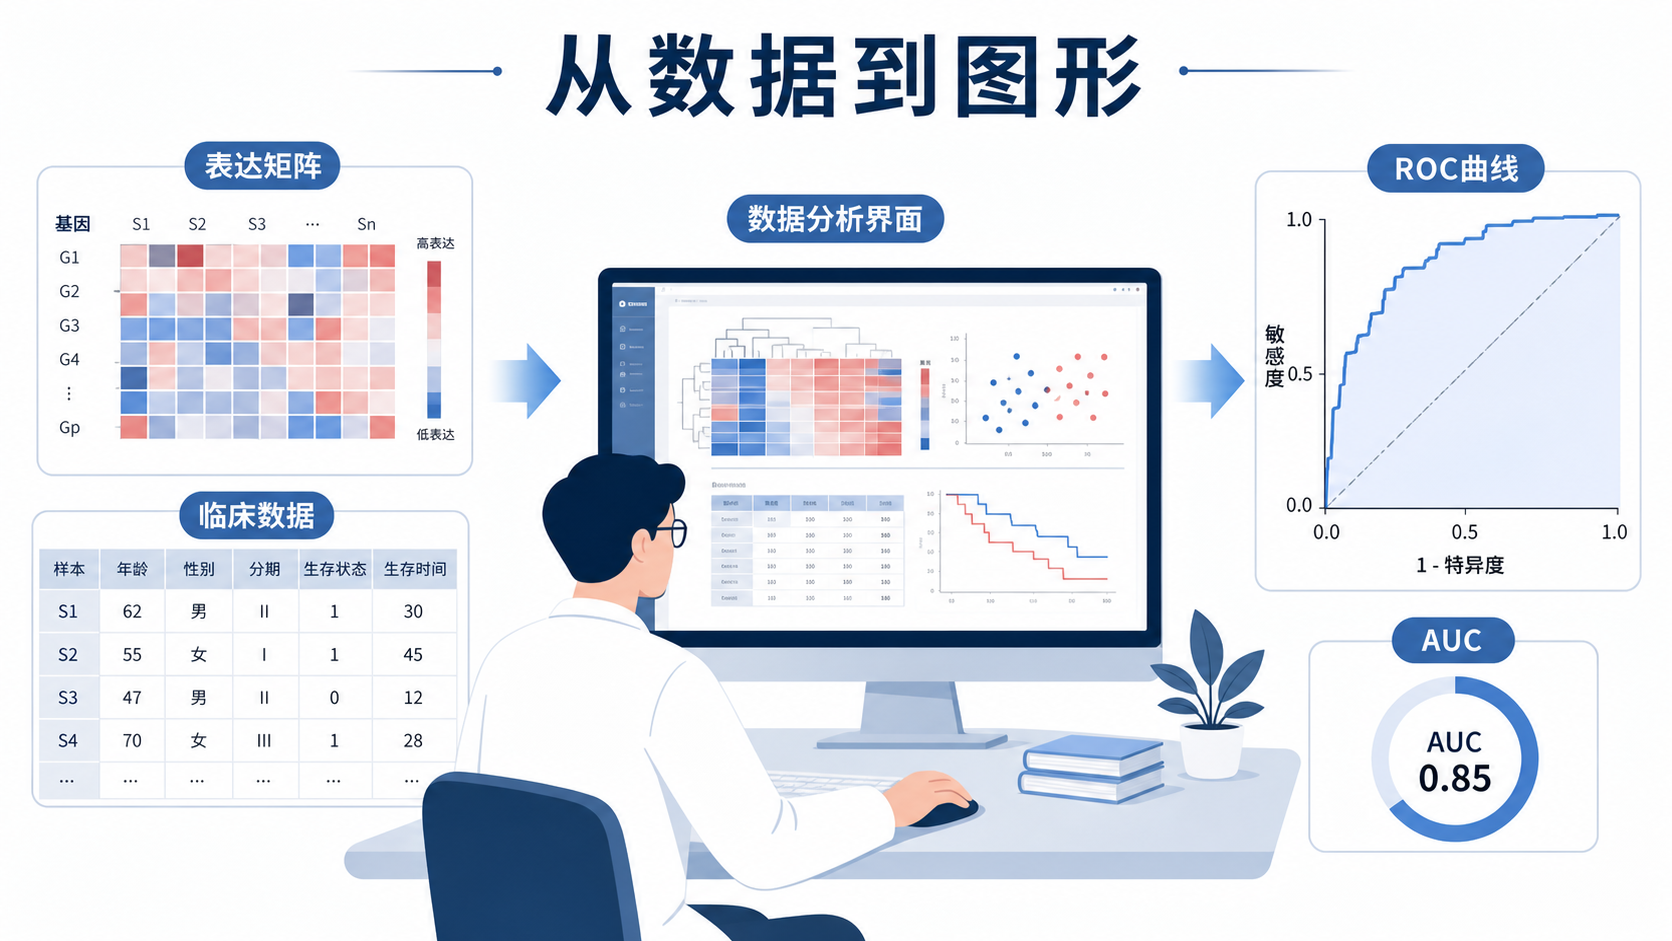
1. ROC曲线在生信研究中的作用
1.1 ROC曲线回答的核心问题
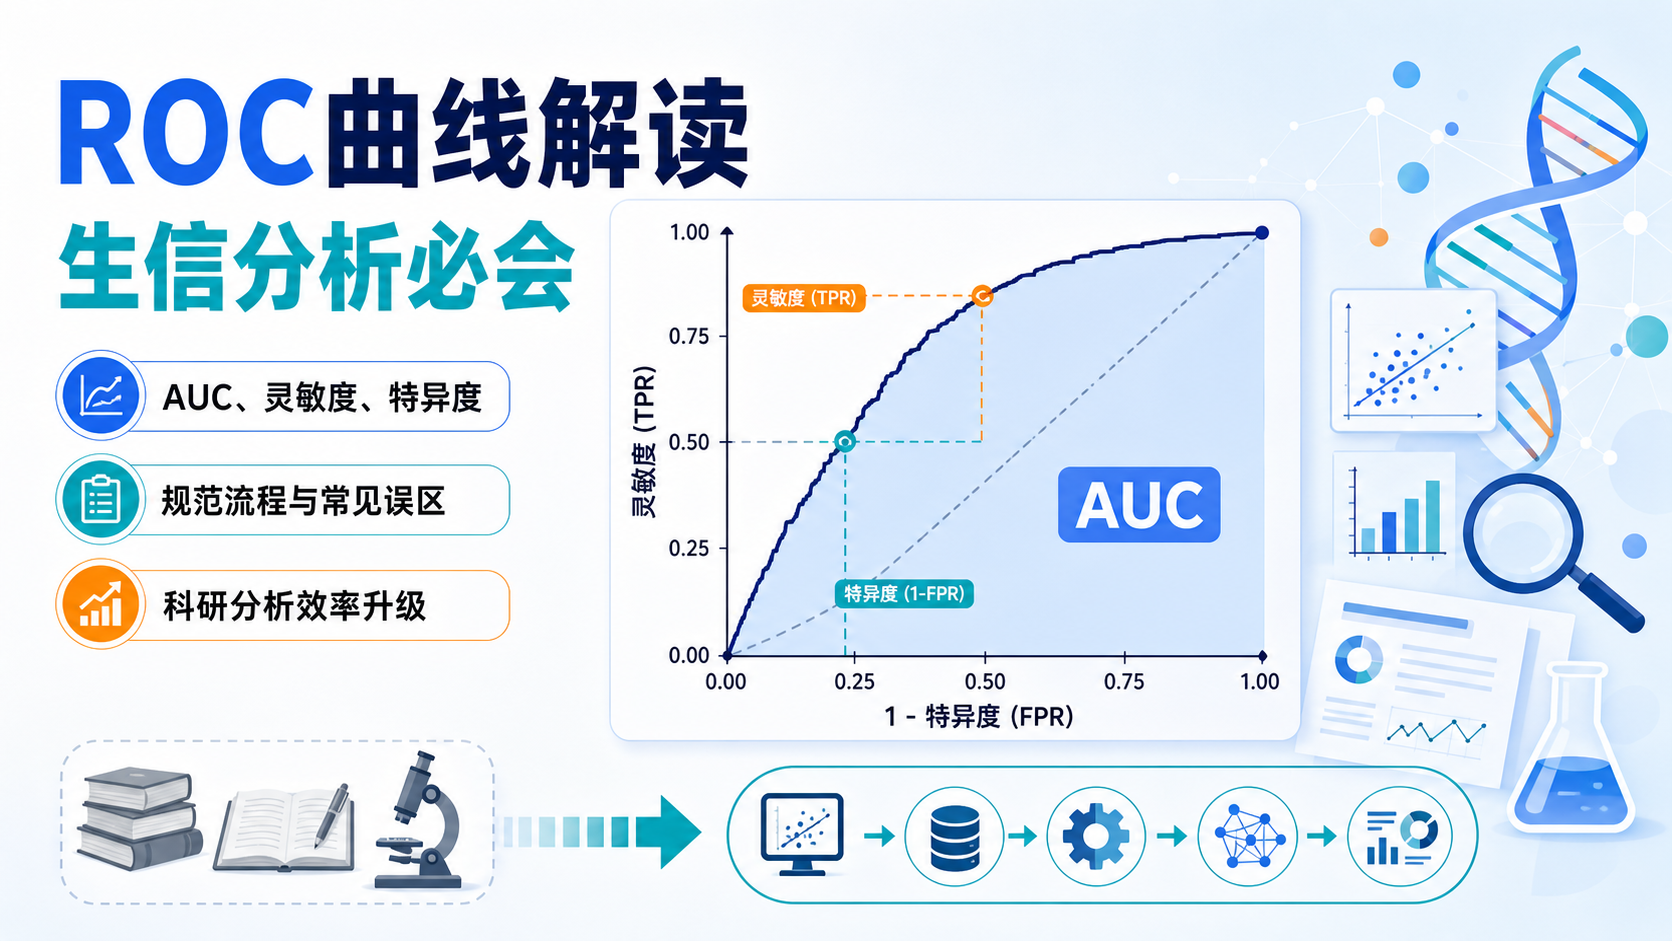
ROC曲线本质上是在回答一个问题。某个指标能不能把病例和对照区分开。
在诊断研究中,它常用于评估基因表达、蛋白水平、风险评分或模型输出的判别能力。
ROC曲线的两个核心量是灵敏度和特异度。
灵敏度越高,漏诊越少。特异度越高,误诊越少。
曲线下面积AUC则是整体区分能力的汇总指标。AUC越接近1,模型判别能力越强。
1.2 论文里为什么常把ROC和复合图一起展示
单独一张ROC图只能说明“能不能分开”,但不能完整支撑一个结论。
所以在实际文章里,ROC常和下面几类图联合出现。
- 生存分析图,用于展示预后差异。
- 热图或表达分布图,用于展示样本分层。
- 列线图或校准曲线,用于展示临床应用价值。
- PRC曲线,用于类别不平衡场景下的补充评价。
复合图的价值在于,把“发现、验证、解释”放到同一套证据链里。
这也是生信文章更容易被接受的原因。
2. ROC曲线绘制前,先把数据准备对
2.1 先确认数据类型和研究目的
ROC不是拿到数据就能直接画。
先要明确你要评估的是单一标志物,还是一个预测模型。
如果是单一基因,通常需要两类信息。
一类是表达量或检测值。另一类是分组标签,比如病例和对照。
如果是模型,则要先得到每个样本的预测概率或风险值。
ROC评估的是“预测结果”和“真实结局”之间的区分能力。
这里最容易出错的是数据类型。
分组标签必须是明确的二分类。
表达量或评分要能与样本一一对应。
字符型变量、缺失值、样本名错位,都会影响最终结果。
2.2 生信数据常见的预处理步骤
在真实项目中,建议按下面顺序处理。
- 读取表达矩阵和表型数据。
- 统一样本ID。
- 提取目标基因或目标特征。
- 合并表达数据和临床分组。
- 检查缺失值和异常值。
- 将分组变量转换为二分类因子。
如果前面的数据合并有误,后面的AUC再漂亮也没有意义。
这是ROC分析里最常见、也最隐蔽的问题。
2.3 单基因和模型ROC的区别
单基因ROC通常更直接。
例如以某个基因表达量区分病例和对照,适合做初步诊断价值评估。
模型ROC则更接近真实应用。
它可能来自多因素回归、LASSO筛选后建模,或机器学习预测结果。
此时输入ROC分析的不是原始表达值,而是每个样本的预测值 。
这也是为什么很多文章会先做多因素分析,再计算风险值。
因为只有先有模型,后面才能谈ROC、校准和临床应用。
3. ROC曲线的标准绘制流程
3.1 先得到预测值,再进入ROC分析
ROC绘制的关键,不是画图函数本身,而是前面的预测值构建。
在模型场景下,常见流程是先用回归模型得到线性预测值或风险分数,再用它作为输入。
流程可以概括为三步。
- 先建立可解释的统计模型。
- 再为每个样本生成预测值。
- 最后用ROC函数计算AUC并作图。
如果是多因素模型,建议先做变量筛选,再进入建模。
这样可以减少冗余变量,也更利于后续解释。
3.2 绘图时最常见的参数关注点
ROC图看似简单,但很多细节会影响可读性。
- 是否显示AUC数值。
- 是否显示置信区间。
- 是否添加参考对角线。
- 是否平滑曲线。
- 是否统一坐标范围。
- 是否与其他曲线放在同一画布中。
对于投稿图,最重要的是统一风格。
同一篇文章里,如果不同图的字体、线宽、颜色、坐标不一致,会明显降低专业感。
在实际操作中,ROC图通常会保留三项信息。
一是曲线本身。二是AUC值。三是随机分类的参考线。
这三项足以支持基本结论。
3.3 AUC怎么解读才准确
AUC是最常被引用的指标,但也最容易被过度解读。
它的含义是:随机抽取一个阳性样本和一个阴性样本,模型把阳性样本评分排在前面的概率。
常见经验判断如下。
- AUC=0.5,说明没有区分能力。
- 0.7到0.8,说明区分能力一般。
- 0.8到0.9,说明区分能力较好。
- 大于0.9,说明区分能力很强。
但要注意,AUC高不等于临床一定可用。
还要看样本量、外部验证、校准情况,以及是否存在类别不平衡。
4. 从单张ROC到复合图,关键是图层管理
4.1 为什么要做复合图
复合图不是为了“好看”,而是为了“讲清楚”。
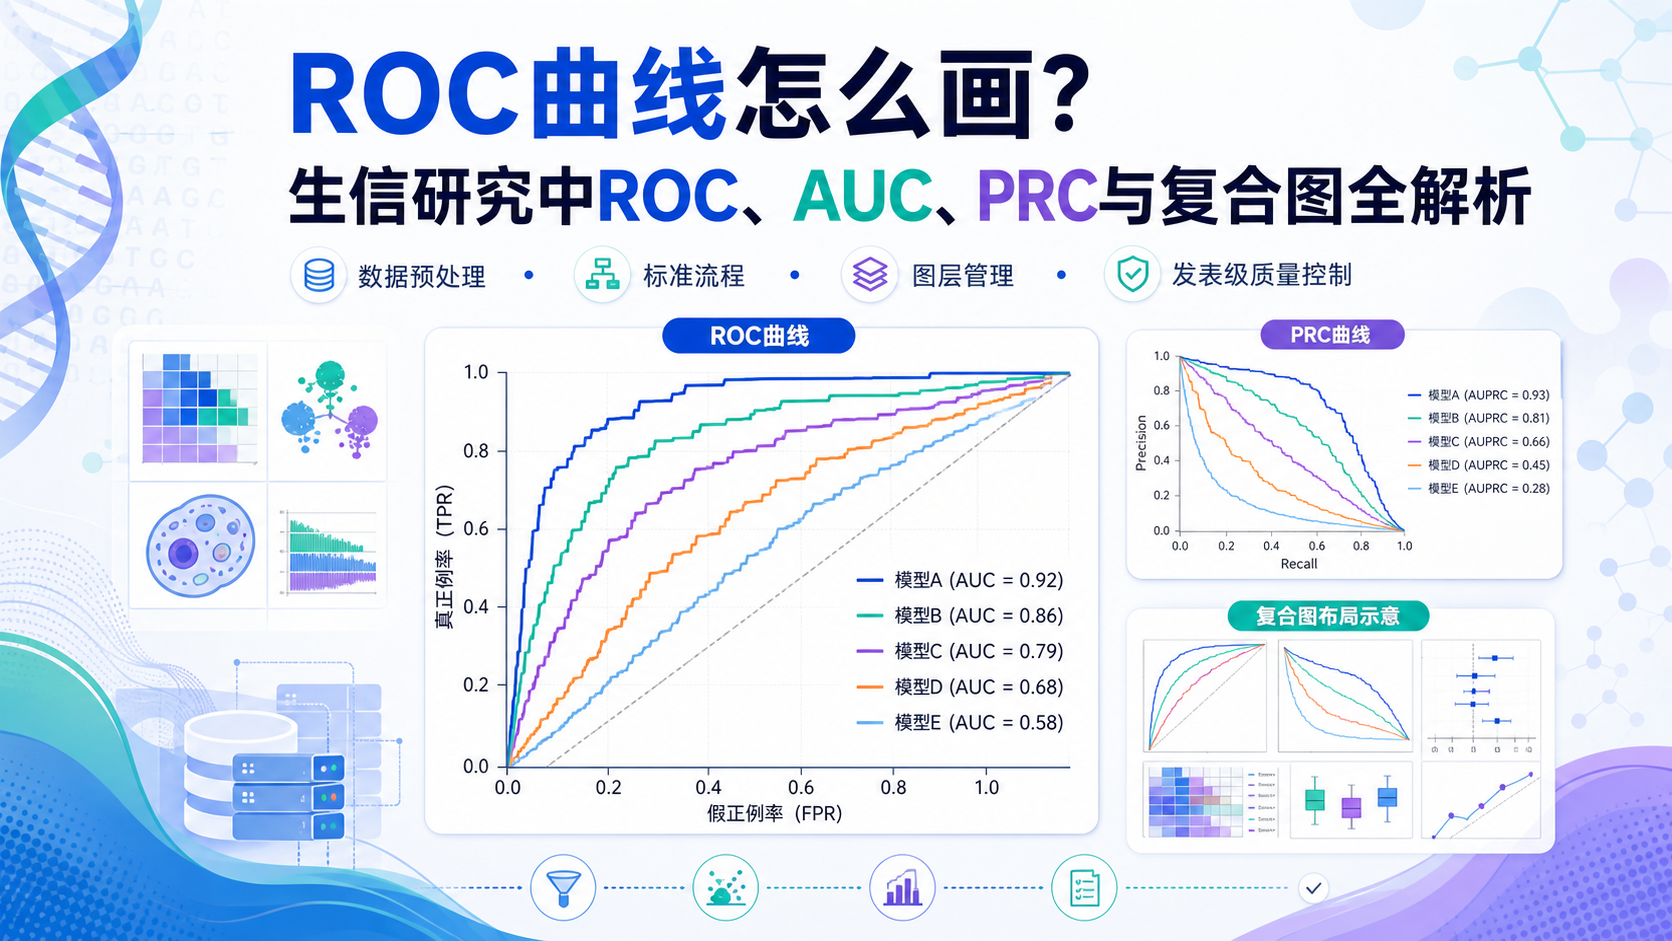
一张图里放入多个ROC曲线,可以比较不同变量或不同时间点的预测能力。
常见场景包括:
- 比较多个基因的诊断能力。
- 比较模型与单基因的性能差异。
- 比较不同时间点的生存ROC。
- 同时展示ROC和其他辅助图。
复合图的核心不是堆图,而是建立比较关系。
4.2 复合图设计的三个原则
第一,比较对象要明确。
不要把无关曲线放在一起,否则读者无法判断重点。
第二,颜色和线型要区分清楚。
建议使用稳定的配色方案,避免曲线数量多时发生颜色复用。
第三,图例信息要完整。
每条曲线最好对应一个AUC值,必要时可加95%置信区间。
如果一张图中有多条ROC曲线,建议控制在5到8条以内。
太多会造成视觉拥挤,也会降低判读效率。
4.3 多条ROC放在一张图里的注意事项
多条曲线叠加时,最容易出错的是坐标和图层顺序。
先画底板,再逐条叠加曲线,是更稳妥的方法。
同时要注意不同曲线的可读性。
如果所有线都很接近,建议增加线型区分。
如果存在明显差异,可以直接用颜色区分。
复合图的目标是让审稿人一眼看出谁更强、谁更稳定。
这比单纯展示一张ROC更有说服力。
5. ROC曲线和PRC曲线的区别
5.1 PRC在什么场景下更有价值
ROC适合多数二分类场景。
但当阳性样本很少时,ROC可能显得过于乐观。
这时PRC曲线更有参考价值。
PRC关注的是精确率和召回率。
它更能反映少数类识别能力。
在基因筛选、稀有事件预测、阳性率很低的队列中,PRC常常更敏感。
如果你的研究存在类别不平衡,建议不要只看ROC。
5.2 ROC和PRC不是替代关系
很多初学者以为两者只能选一个。
其实更合理的做法是联合使用。
- ROC适合看整体区分能力。
- PRC适合看阳性类识别质量。
- 两者结合,能更全面评估模型。
对于医学生和科研人员来说,这一点很重要。
因为真实数据中,很多疾病并不是均衡分布。
如果只看ROC,可能会高估模型价值。
6. 发表级ROC图的质量控制要点
6.1 先做内部验证,再谈模型结论
如果ROC来自训练集,必须谨慎解释。
训练集AUC往往偏高。
更稳妥的做法是做交叉验证或独立验证。
常见验证方式包括:
- 留出法验证。
- 交叉验证。
- 外部数据集验证。
- Bootstrap重复抽样。
没有验证的高AUC,只能算初步结果,不能直接当作临床证据。
6.2 图注和正文要写清楚什么
正文中不要只写“ROC结果良好”。
应尽量说明以下信息。
- 使用了什么数据集。
- 评估的是单基因还是模型。
- AUC具体数值是多少。
- 是否进行了外部验证。
- 是否存在类别不平衡。
如果是复合图,还要交代每条曲线对应什么变量。
这样读者才能理解图和结论之间的关系。
6.3 常见错误
以下问题在投稿中很常见。
- 样本标签写反。
- 预测值和结局变量顺序错位。
- 把连续变量误当成分组变量。
- 缺失值未处理。
- 训练集和验证集混用。
- 图例缺失,无法区分曲线。
ROC图最怕“看起来正确,实际上数据错了”。
所以在出图前,最好再次核对样本ID、分组标签和预测值顺序。
总结Conclusion
ROC曲线绘制看似简单,实则涉及数据整理、模型构建、预测值生成、AUC计算和图形整合多个环节。对于生信研究来说,真正重要的不是画出一张曲线,而是让ROC结果能够与模型、分组和临床问题形成闭环 。如果你希望更高效地完成从数据到复合图的整套流程,可以借助解螺旋的生信实操资源,减少重复试错,把精力放在结果解释和论文产出上。

- 引言Introduction
- 1. ROC曲线在生信研究中的作用
- 2. ROC曲线绘制前,先把数据准备对
- 3. ROC曲线的标准绘制流程
- 4. 从单张ROC到复合图,关键是图层管理
- 5. ROC曲线和PRC曲线的区别
- 6. 发表级ROC图的质量控制要点
- 总结Conclusion