6
 分享

引言Introduction
列线图评分很常见,但真正能发高分的文章不多。问题不在“会不会画图”,而在于变量筛选、模型验证、临床可解释性是否经得住审稿人追问。高分论文看的是完整方法链,而不是一张好看的图。 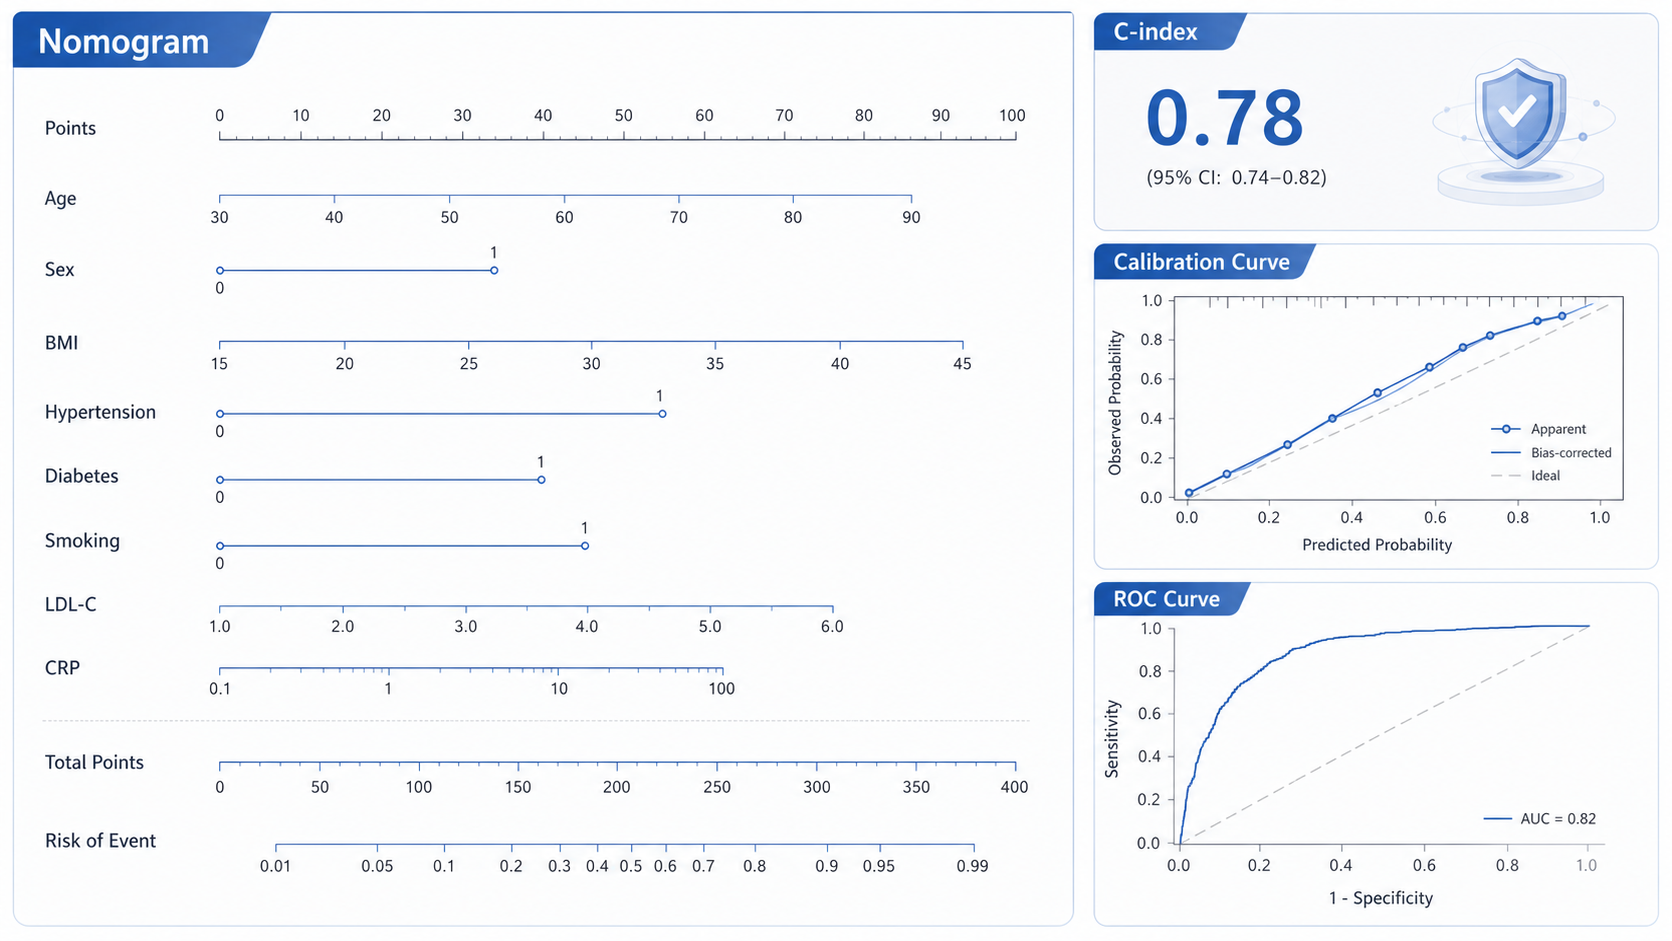
1. 列线图评分为什么容易“看起来能发,实际上难过审”
1.1 审稿人真正关注的不是“画出来”,而是“能不能用”
列线图的本质,是把多个变量整合成一个可计算的个体化风险评分。它常用于预后研究、临床决策支持和风险分层。
但审稿人不会只看“有没有列线图”。他们会追问三个问题:
- 变量是否有明确临床意义。
- 模型是否稳定,是否过拟合。
- 预测结果是否真的优于传统方案。
如果模型只是把几个P值显著的变量拼在一起,通常很难进入高分期刊。 原因很简单,统计上“显著”不等于临床上“有用”。
列线图评分能否发表,核心取决于研究设计是否完整。常见问题包括:
- 样本量偏小。
- 事件数不足。
- 变量筛选过度依赖单因素分析。
- 缺少外部验证。
- 只做ROC,不做校准和临床净获益分析。
1.2 高分文章通常不是“单图胜出”,而是方法闭环
高质量列线图论文往往遵循一条清晰路径。
先建模,再验证,再比较,最后解释临床意义。
典型流程是:
- 明确结局指标,如总生存、无进展生存、复发风险。
- 通过单因素和多因素回归筛选变量。
- 构建列线图评分。
- 进行内部验证和外部验证。
- 用C-index、AUC、校准曲线、DCA证明模型价值。
审稿人最看重的是:模型是否真的比传统临床分层更好。
如果结论只是“我们构建了一个列线图”,文章价值通常有限。
2. 列线图评分的统计基础,决定文章上限
2.1 变量筛选不能只靠“单因素显著”
很多作者习惯先做单因素Cox回归,再把P<0.05的变量放进多因素模型。这个流程并非不能用,但不能机械照搬。
原因有两个:
- 单因素显著不代表独立预测因子。
- 过多变量进入模型,容易产生多重共线性和过拟合。
更稳妥的做法包括:
- 优先选择临床上合理的候选变量。
- 检查变量之间的相关性。
- 控制事件数与变量数的比例。
- 必要时采用LASSO等降维方法。
经验上,事件数少、变量多、样本量不足,是列线图评分论文最常见的硬伤。
如果模型里变量太多,C-index在训练集很漂亮,验证集却明显下降,审稿人通常会质疑稳健性。
2.2 回归模型要服务于结局,不要为了“上图”而建模
列线图常基于Cox回归。如果是二分类结局,也可能用Logistic回归。
选择哪种模型,取决于结局类型和随访结构。
要特别注意以下几点:
- 时间结局优先考虑生存分析框架。
- 连续变量不要盲目二分。
- 分类阈值要有临床或统计依据。
- 缺失值处理要透明说明。
把连续变量简单切成高低组,常常会损失信息,也会降低模型性能。
除非阈值有明确依据,否则这种处理方式很容易被审稿人挑战。
2.3 列线图评分的“高分感”来自验证体系
高分文章几乎都会强调验证。验证不是可有可无,而是决定可信度的核心。
建议至少包含三层:
- 内部验证 ,如bootstrap重抽样。
- 时间验证 ,如不同入组时间段验证。
- 外部验证 ,如独立中心数据验证。
如果只有训练集结果,文章通常不够强。
如果有外部验证,且性能保持稳定,文章说服力会显著增强。
3. 审稿人最常盯的四类统计指标
3.1 区分度,模型能不能把高风险和低风险分开
区分度是列线图评分最基础的指标。
生存模型中最常见的是C-index,值越高,说明模型区分能力越强。一般来说,0.5接近随机,越接近1越好。
也常见时间依赖ROC曲线,用于评估不同时间点的预测能力。
但要注意,AUC高不代表模型就一定好。 如果校准差、临床获益低,依然不够。
3.2 校准度,预测值和真实值是否一致
校准曲线非常关键。
它回答的是:模型预测的概率,和真实发生率是否一致。
如果列线图预测3年生存率是70%,实际也是接近70%,说明校准较好。
如果偏差很大,说明模型“会算,但算不准”。
审稿人通常会看:
- 校准曲线是否贴近45度线。
- 是否做了Hosmer-Lemeshow检验或等效分析。
- 验证集校准是否仍然稳定。
3.3 临床净获益,模型是否真的有用
高水平文章越来越重视DCA,Decision Curve Analysis。
它不是看统计显著,而是看临床净获益。
DCA回答的问题很直接:
- 用这个模型决策,是否比“全部干预”或“全部不干预”更划算。
- 在什么阈值范围内,模型最有价值。
如果没有DCA,很多审稿人会认为文章只停留在统计层面,没有落地到临床。
3.4 分层能力,模型能否指导临床分组
列线图评分最终往往要回到临床分层。
也就是把患者分成高风险和低风险组,观察生存曲线是否明显分离。
这一步常与Kaplan-Meier曲线联用。
如果高低风险组曲线明显分开,说明模型具备实际分层价值。
但要注意,分组阈值不能随意选择。
阈值来源应说明清楚,最好有方法学依据,而不是“为了让曲线更好看”。
4. 高分论文和普通论文的差别,往往在这些细节
4.1 变量来源要有逻辑,而不是“能取到什么就放什么”
高分论文通常会说明变量选择的理论依据。
例如肿瘤相关研究会优先考虑:
- 年龄。
- 分期。
- 病理分级。
- 治疗方式。
- 生物标志物。
如果变量选择过于随意,文章的可信度会下降。
模型不是变量堆砌,而是机制、临床和统计的统一。
4.2 研究终点要定义清楚
很多列线图文章的问题出在终点定义不严谨。
例如总生存、癌症特异生存、无复发生存,三者不能混用。
结局定义不清,会导致:
- 统计模型不一致。
- 结果难以复现。
- 临床解释混乱。
审稿人往往会问:
这个终点是否足够稳定,是否受到治疗策略变化影响,随访是否充分。
4.3 报告规范决定文章可发表性
列线图文章建议遵循TRIPOD等报告规范。
这类规范会要求作者清楚说明:
- 数据来源。
- 纳排标准。
- 缺失值处理。
- 模型构建过程。
- 验证方法。
- 性能评价指标。
报告越规范,越容易通过统计和方法学审稿。
很多“拒稿”并不是因为模型不好,而是因为方法写得不完整。
5. 审稿视角下,列线图评分最容易被质疑的点
5.1 样本量与事件数是否足够
这是最常见的质疑点。
如果事件数太少,模型就不稳定。尤其是变量多、样本小的时候,过拟合风险很高。
审稿人会关注:
- 样本量是否支持建模。
- 训练集和验证集是否合理分配。
- 是否进行了敏感性分析。
5.2 是否存在信息泄漏
如果在全数据上先筛变量,再分训练集和验证集,就可能造成信息泄漏。
这会让模型性能虚高。
更规范的做法是:
- 先划分数据集。
- 再在训练集中建模。
- 最后在验证集中评价。
5.3 是否真正优于传统分期系统
列线图评分最重要的价值,不是“新”,而是“更好”。
审稿人会问:
它比TNM分期、传统临床评分或单一指标强多少。
因此,建议进行对比分析:
- 与单因素模型比较。
- 与传统分期系统比较。
- 与已有预测工具比较。
如果优势不明显,文章创新性就会被削弱。
6. 如何让列线图评分更像高分文章
6.1 先做“可发表”,再追求“高分”
不要一开始就追求复杂算法。
很多时候,结构完整、验证充分、解释清楚的传统模型,比“花哨但不稳”的模型更容易发表。
建议优先保证:
- 临床问题明确。
- 变量选择有依据。
- 统计流程规范。
- 验证充分。
- 结果解释到位。
6.2 让模型服务于临床决策
高分列线图论文的终点,不是“画出一个图”,而是“帮助医生做决策”。
比如:
- 谁需要更密切随访。
- 谁适合强化治疗。
- 谁属于低风险人群,可避免过度治疗。
只要能把模型和临床动作对应起来,论文的价值就会明显上升。
6.3 用规范工具提升论文完成度
如果你在做列线图评分研究,建议从一开始就按规范准备材料。
尤其是数据整理、统计方案、图表输出和结果解释。
这类工作如果靠手工反复修改,效率很低。
而像解螺旋这类科研支持工具,可以帮助你更快梳理统计逻辑、优化图表表达、规范论文结构,让你把精力集中在模型本身和临床问题上。对医学生、医生和科研人员来说,这类工具的价值不只是省时间,更是减少方法学漏洞。
总结Conclusion
列线图评分要发高分,关键不在“图漂亮”,而在统计链条是否完整。
变量筛选要合理,建模要稳健,验证要充分,临床价值要说清。
审稿人最看重的是模型是否可信、是否可推广、是否真能指导临床。
如果你正在做列线图评分研究,不妨按“问题定义、模型构建、内部验证、外部验证、临床解释”这条线重新检查一遍。这样能显著提高文章质量和中稿概率。若希望更高效地打磨研究框架、统计表达和论文结构,也可以结合解螺旋的科研支持方案,让你的列线图研究更接近高分发表标准。

- 引言Introduction
- 1. 列线图评分为什么容易“看起来能发,实际上难过审”
- 2. 列线图评分的统计基础,决定文章上限
- 3. 审稿人最常盯的四类统计指标
- 4. 高分论文和普通论文的差别,往往在这些细节
- 5. 审稿视角下,列线图评分最容易被质疑的点
- 6. 如何让列线图评分更像高分文章
- 总结Conclusion