26
 分享
引言Introduction
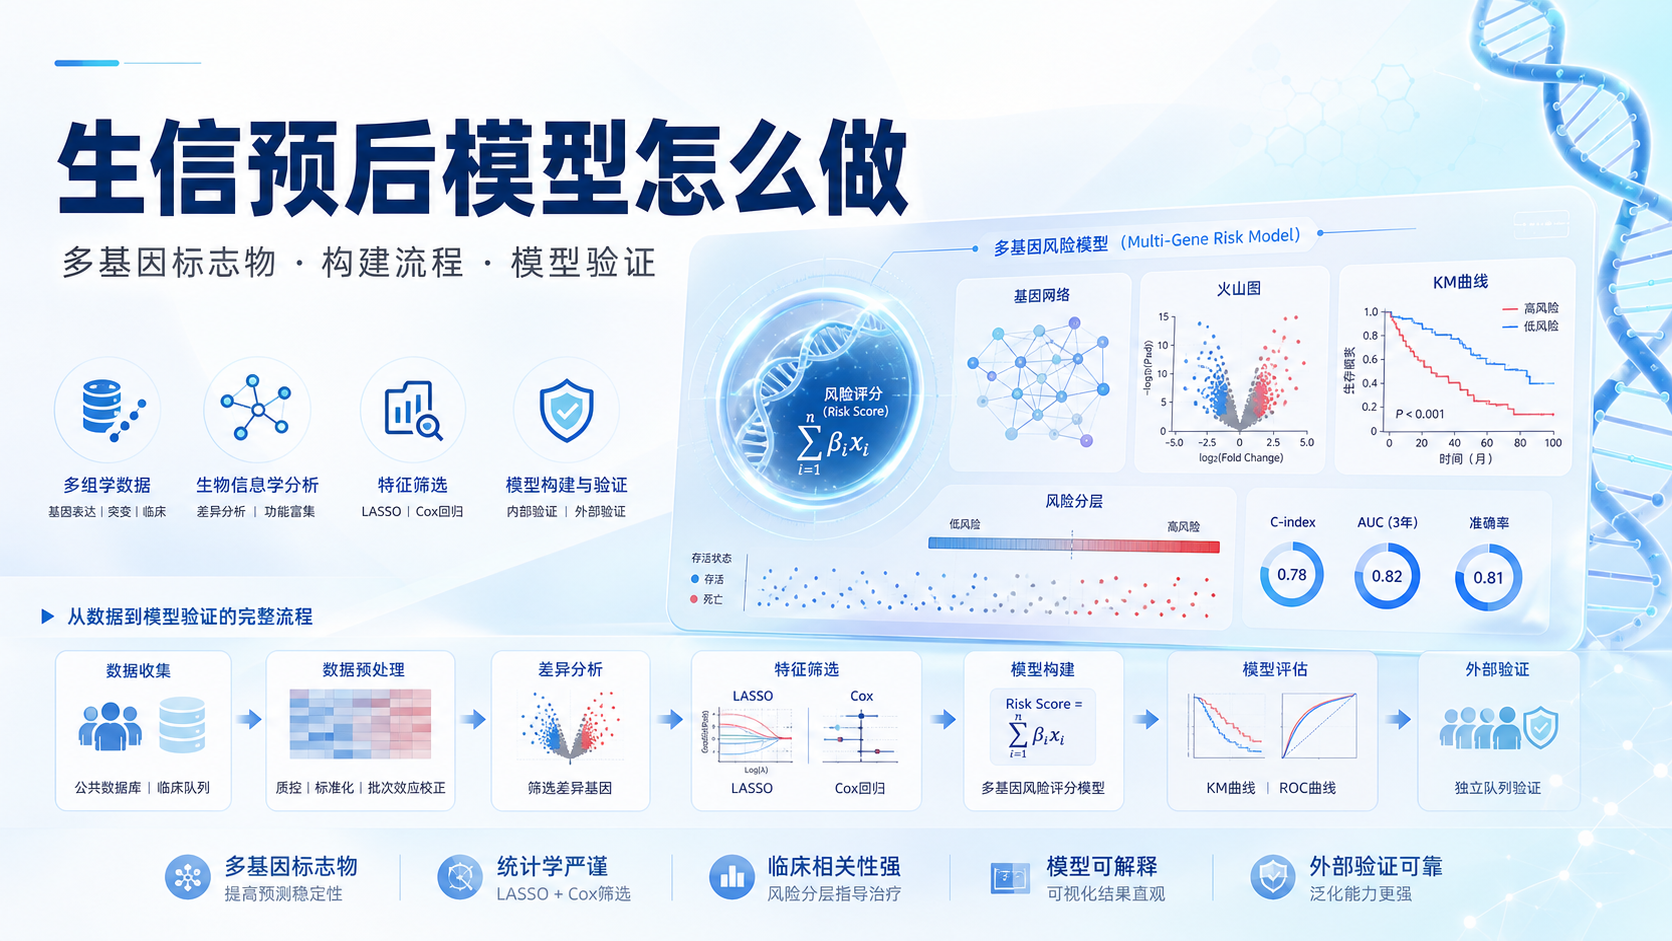
生信预后模型不是简单把几个基因塞进公式。真正难点在于,如何从海量候选基因里筛出稳定、可解释、可验证的标志物 ,并把它们转化为能落地的临床风险评分。对医学生、医生和科研人员来说,最常见的问题是,结果能做出来,但模型不稳,外部验证不过,临床意义也讲不清。
1. 生信预后模型的核心逻辑
1.1 先明确模型要回答什么问题
预后模型的目标,不是“找几个差异基因”。而是回答一个更具体的问题,哪些分子能够稳定预测患者结局 。常见结局包括总体生存、无进展生存、无病生存和疾病特异性生存。
在实际研究中,模型通常由两部分组成。第一部分是特征筛选。第二部分是风险建模。前者决定“选谁”,后者决定“怎么算”。如果这一步逻辑不清,后面的ROC、KM曲线和列线图都只是形式。
1.2 多基因标志物比单基因更接近临床
单基因研究适合切入,但临床稳定性有限。多基因标志物的优势在于,它能整合多个生物学维度,降低单一分子波动带来的偏差 。这也是为什么很多预后模型最终会走向signature,而不是停留在单个基因。
但多基因并不等于越多越好。基因数过多会带来过拟合。尤其在样本量有限时,模型在训练集表现很好,到了验证集就明显下滑。因此,控制特征数量,是构建高质量预后模型的第一原则。
2. 生信预后模型构建的标准流程
2.1 从数据集到候选基因
常见数据来源包括GEO、ArrayExpress和TCGA。对于肿瘤研究,TCGA更适合做带临床结局的分析。对于非肿瘤研究,很多时候只能依赖公开表达谱数据和有限临床信息,因此更要重视数据清洗和样本筛选。
通常流程是:
- 统一表达矩阵和临床信息。
- 去除生存时间缺失、结局信息不完整的样本。
- 筛选差异表达基因。
- 结合单因素Cox分析锁定与生存相关的候选基因。
这一步的关键,不是“多找几个基因”,而是先把不可靠样本排干净 。样本质量直接决定模型上限。
2.2 用LASSO和Cox缩小到核心特征
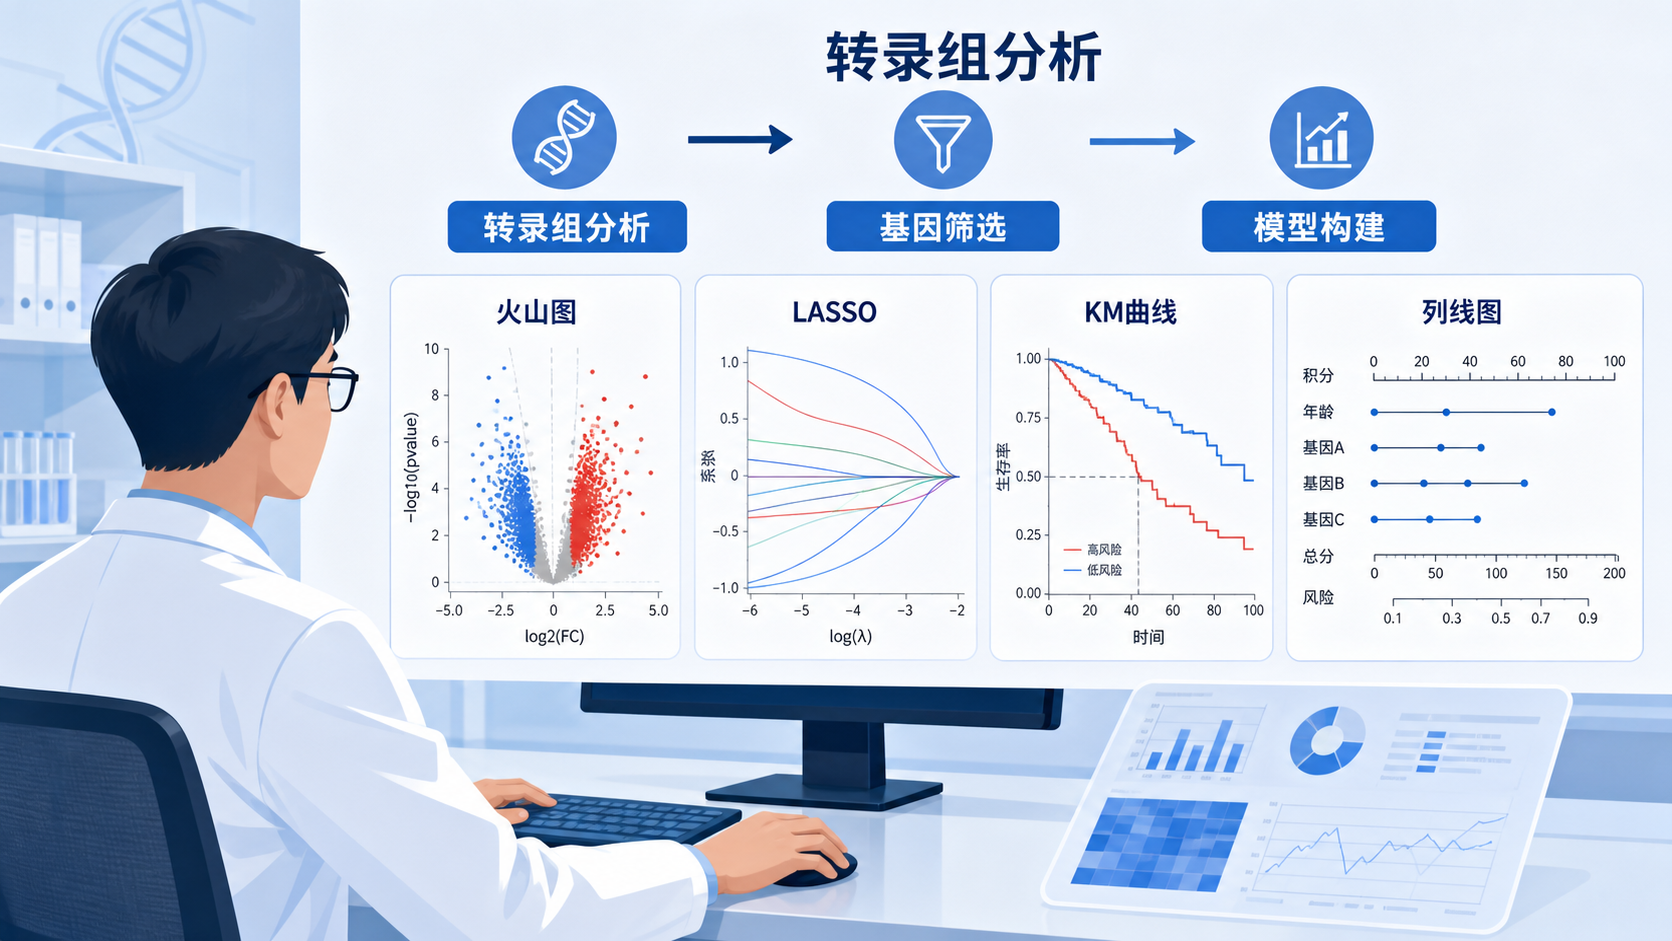
在多基因标志物实战中,最常见的组合是单因素Cox加LASSO,再接多因素Cox。LASSO的价值在于压缩特征,减少共线性影响。它适合从几十个、上百个候选基因中筛出更稳定的组合。
常见做法是:
- 先做单因素Cox,找出和生存显著相关的基因。
- 再用LASSO回归进一步降维。
- 最后进入多因素Cox,确定每个基因的回归系数。
这里要注意,LASSO选出来的不一定就是最终最佳模型 。它只是帮助你在复杂特征中找到更精简的组合。真正决定模型可靠性的,还是后续验证。
2.3 计算风险评分并分组
得到最终基因后,就可以建立风险评分公式。一般形式为:
风险评分 = Σ(基因表达量 × 回归系数)
然后按中位数或最佳cutoff分为高风险组和低风险组。接着比较两组生存差异。如果高风险组的生存显著更差,说明这个评分具有预后区分能力。
这一环节最重要的是,评分必须有明确的生物学和统计学依据 。不能只看P值,还要看效应方向是否一致,是否符合先前数据趋势。
3. 模型验证决定文章能不能站住
3.1 KM曲线只是第一步
很多研究停留在KM曲线显著,但这远远不够。KM只能说明分组后存在生存差异,不能证明模型有良好的预测性能。真正完整的预后模型,至少要补齐三个维度。
- 校准度,预测值和真实值是否一致。
- 区分度,模型能否把高危和低危分开。
- 临床获益,模型是否真的有应用价值。
3.2 校准度、区分度和DCA缺一不可
校准曲线常用于评估1年、3年、5年预测的一致性。曲线越接近45度对角线,说明预测越可靠。对于临床研究来说,校准度是模型可信度的重要基础 。
区分度通常看C-index和时间依赖ROC。AUC越高,说明模型识别高低风险的能力越强。很多预后模型要求AUC至少达到0.70以上,较好的模型通常更高。但要注意,单看AUC不够,必须结合样本分层和外部验证。
DCA曲线则更贴近临床决策。它回答的是,使用这个模型后,患者是否真的受益。一个只能“统计学显著”的模型,不一定是临床有用的模型。 DCA能帮助你把研究从“可看”推进到“可用”。
3.3 外部验证是模型的分水岭
如果条件允许,必须做外部验证集。训练集表现再好,没有外部验证都难以说明稳健性。外部验证可以来自独立队列,也可以来自不同平台数据。关键是,数据来源要尽量独立。
在实际写作中,外部验证的价值很大。它不仅提升文章可信度,也能明显增强审稿人对模型泛化能力的认可。
4. 多基因标志物实战中的常见问题
4.1 样本量不足,模型容易过拟合
这是最常见的问题。基因数越多,样本量要求越高。样本太少时,模型会把噪音当成信号。解决方法包括:
- 降低特征数量。
- 严格划分训练集和验证集。
- 优先选择稳定的公开数据。
- 尽量使用交叉验证减少偏差。
4.2 临床变量整合不充分
一个合格的预后模型,不能只停留在基因层面。还要看它和年龄、分期、分级、治疗方式等临床变量的关系。通常要做单因素和多因素Cox分析,判断风险评分是否独立于临床因素。
如果评分可以作为独立预后因子,模型说服力会明显增强。进一步还可以构建列线图,把基因评分和临床变量整合起来,形成更直观的预测工具。
4.3 生物学解释不足
很多模型的问题不在统计,而在解释。审稿人会问,为什么是这几个基因?它们和疾病机制有什么联系?所以,模型建立后还要做功能富集、PPI网络、免疫浸润或通路分析,补足机制链条。
这一步不是装饰,而是让模型从“能算”变成“能解释”。没有机制支撑的预后模型,通常很难进入高质量发表。
5. 适合医学生和科研人员的实战思路
5.1 用最小可行路径做起
如果你是初学者,建议按下面的顺序做:
- 找疾病相关数据集。
- 做差异分析。
- 做单因素Cox筛选。
- 用LASSO降维。
- 建立多因素Cox模型。
- 做KM、ROC、校准和DCA。
- 加入临床变量做整合模型。
- 完成外部验证。
这套路径最稳,也最适合形成标准化文章框架。对于大多数医学科研项目来说,一套规范的预后模型流程,往往比复杂但不稳的分析更有发表价值 。
5.2 让模型服务于后续实验
如果你后面还要做湿实验,生信预后模型可以先帮你缩小范围。它能筛出最值得验证的基因组合,减少盲目试错。对于经费有限、时间紧张的课题组,这一步尤其重要。
在这个环节,解螺旋这类生信产品的价值就很明显。它能帮助你更高效地完成数据清洗、特征筛选、模型构建和可视化输出,把原本零散的分析流程整合成可复现的研究路径。对想快速搭建生信预后模型的人来说,这比从头摸索更省时间,也更容易把结果做稳。
总结Conclusion
生信预后模型构建的本质,是从公共数据中找到稳定的生存相关特征,并通过统计建模和多层验证证明其临床价值。真正高质量的多基因标志物,必须同时满足三个条件,能区分、能校准、能解释 。如果你正在做相关课题,建议优先采用“单因素筛选,LASSO降维,多因素建模,外部验证”的标准流程。想更高效地推进研究,也可以借助解螺旋完成生信预后模型构建,加速从数据到文章的转化。

- 引言Introduction
- 1. 生信预后模型的核心逻辑
- 2. 生信预后模型构建的标准流程
- 3. 模型验证决定文章能不能站住
- 4. 多基因标志物实战中的常见问题
- 5. 适合医学生和科研人员的实战思路
- 总结Conclusion