10
 分享
引言Introduction
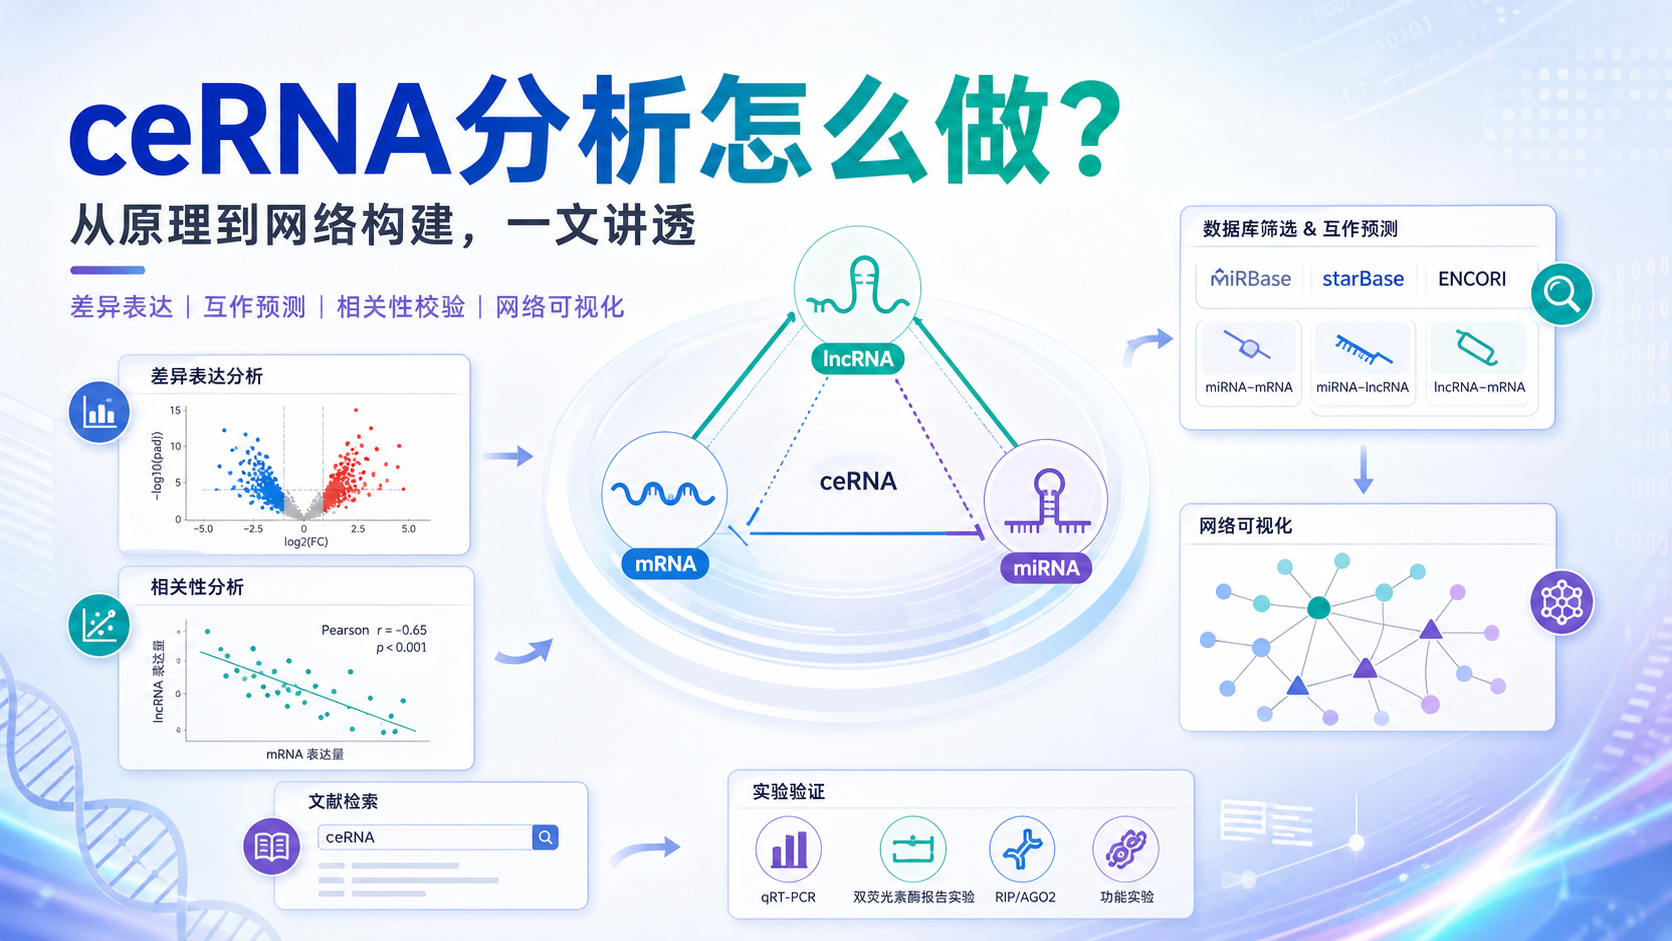
做ceRNA分析时,很多人卡在两点。第一,不知道从哪里入手。第二,文献看了很多,却拼不出完整框架。真正的问题不是不会做,而是不知道如何把数据、数据库、筛选标准和可视化串成一条线。
1. 先理解ceRNA分析的底层逻辑
1.1 ceRNA不是一种新RNA,而是一种调控机制
ceRNA的核心,是RNA之间通过竞争性结合miRNA来影响彼此表达。常见的组合包括mRNA、miRNA和lncRNA,也可以扩展到circRNA。它的本质不是“找几个分子拼网络”,而是证明分子之间存在可解释的调控链条。
在生信研究中,ceRNA分析通常不是单点分析,而是网络分析。你需要先定义候选分子,再验证它们之间是否满足表达相关、靶向关系和生物学一致性。没有这三个层次,ceRNA网络就只是图,不是机制。
1.2 适合ceRNA研究的基本框架
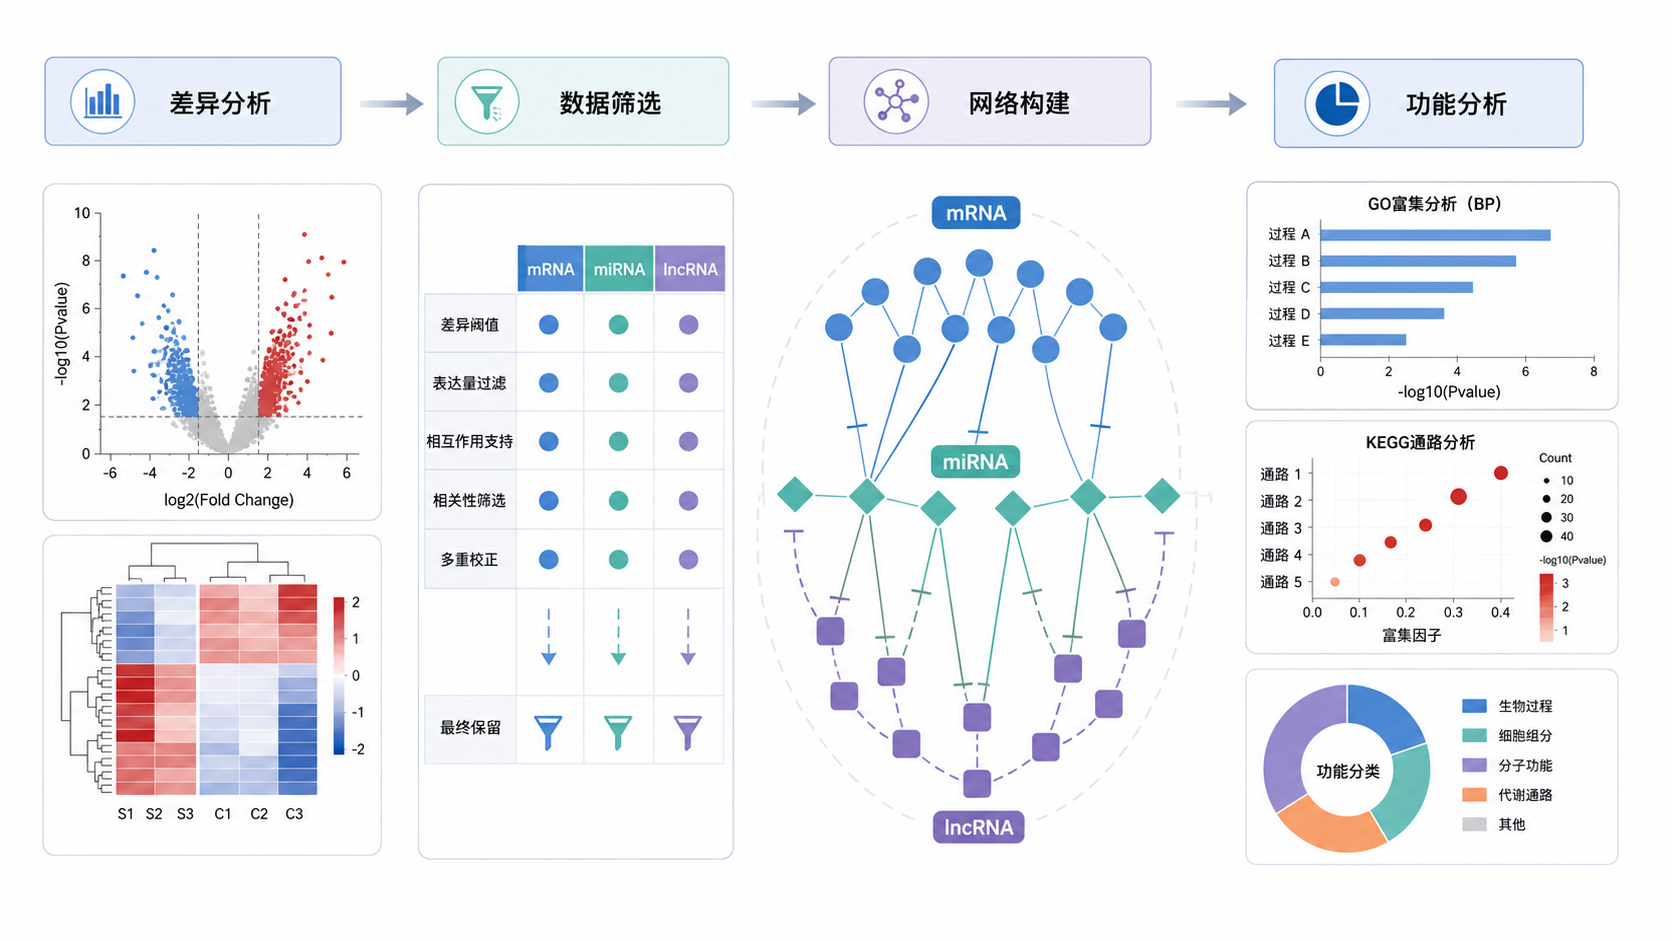
从文献复盘来看,标准的ceRNA研究一般包含以下模块:
- 差异表达分析。
- 靶基因或miRNA预测。
- 交集筛选。
- 相关性分析。
- 富集分析。
- 网络构建与可视化。
- 独立验证或外部验证。
这个框架适用于多数疾病场景。真正拉开文章层次的,不是有没有做ceRNA,而是筛选是否严谨,验证是否充分,逻辑是否闭环。
ceRNA研究很像搭积木。每一步都可以替换工具,但底层顺序不能乱。先有候选,再有过滤,再有验证,最后才是成网。这个逻辑是后续所有分析的主线。
2. 从文献和数据库开始搭建你的研究框架
2.1 先看“别人怎么做”,再决定“自己怎么做”
想快速进入生信ceRNA网络分析,最有效的方法不是盲目上手,而是先精读同类文章。你可以用关键词检索,例如ceRNA、ceRNA研究、GEO、TCGA等,系统浏览近几年的代表性论文。目标不是看热闹,而是总结出固定套路。
重点记录四类信息:
- 研究对象是什么疾病。
- 使用了哪些数据库。
- 每一步用了哪些图。
- 文章的创新点放在哪里。
例如,火山图、热图、GO/KEGG图、PPI图、环状图、桑基图,几乎都是高频出现的图型。你要学的不是“怎么画图”,而是“为什么在这个节点画这张图”。
2.2 数据库选择要服务于研究目的
ceRNA分析常见数据库大致分三类。
- 表达和临床数据来源,如TCGA、GEO。
- miRNA靶向预测数据库,如multiMiR、miRTarBase、TargetScan。
- lncRNA和miRNA互作数据库,如starBase。
课程和实战中常见做法,是先从表达矩阵出发,再结合数据库进行筛选。比如,差异分析后得到一批mRNA,再通过multiMiR预测可能的miRNA,再进一步筛lncRNA。这种做法的优势是流程清晰,适合从mRNA切入构建ceRNA网络。
数据库不是越多越好,而是越匹配越好。如果筛选标准不统一,最后得到的网络会很大,但可信度很低。
2.3 文献复盘时要做“减法”和“加法”
复盘ceRNA文献时,建议你同时做两件事。
第一,做减法。把文章中真正推动结论成立的核心分析挑出来。
第二,做加法。把可增强说服力的补充分析列出来。
常见的加分项包括:
- 多数据库交叉验证。
- 独立验证集。
- 生存分析。
- ROC分析。
- 实验验证,哪怕是基础层面的qPCR或双荧光素酶验证。
高分文章和普通文章的差别,往往不在图多,而在验证链条是否完整。
3. ceRNA网络分析的标准流程
3.1 第一步,做差异表达分析
无论你用TCGA还是GEO,第一步通常都是差异分析。常见工具是limma包。常用阈值包括:
- P < 0.05。
- |logFC| ≥ 1。
如果是更严格的分析,也可能采用更高的fold change阈值。差异分析的目的,是先筛出有可能参与疾病过程的分子,而不是直接宣布它们有机制。
差异分析后,通常会得到DEGs、差异miRNA或差异lncRNA。接下来要做的是分类和取交集。只有在候选范围被压缩之后,ceRNA网络才更容易解释。
3.2 第二步,预测并筛选互作关系
ceRNA网络的关键,不是简单拼接三类RNA,而是建立可信的互作关系。这里一般有两条主线。
一条是mRNA到miRNA的预测。
另一条是miRNA到lncRNA的预测。
以multiMiR为例,它整合了多个数据库,可以帮助你从mRNA端反推可能的miRNA。课程实践中常见做法是先得到大量预测结果,再进一步保留高可信证据。例如,只保留经过实验验证的数据类型。这一步的原则是,预测可以宽,筛选必须严。
对于lncRNA部分,starBase等数据库常用于提取miRNA与lncRNA的互作信息。进一步结合表达数据和筛选阈值后,最终才能把网络收紧到可解释的范围。
3.3 第三步,做相关性分析和方向校验
ceRNA网络不是任意连线。它需要满足基本方向逻辑。通常情况下,miRNA与靶基因呈负相关,而lncRNA与miRNA、靶基因与lncRNA之间的关系,需要结合ceRNA假说来判断。
在实际分析中,常见做法是计算相关系数,并设置阈值,例如:
- |cor| > 0.4 或 0.5。
- P < 0.05 或 P < 0.001。
相关性分析的作用,是把“预测到的互作”进一步缩小成“有表达证据支持的互作”。
如果只看预测不看相关性,网络会太松。
如果只看相关性不看数据库支持,网络会失去机制基础。
3.4 第四步,构建网络并可视化
完成筛选后,就可以把结果导入Cytoscape进行可视化。常见做法包括:
- 用不同颜色区分mRNA、miRNA和lncRNA。
- 用不同形状区分节点类型。
- 调整边的方向和样式。
- 导出高分辨率图片用于论文。
Cytoscape的价值,不只是“把图画出来”,而是帮助你检查网络是否合理。如果一个节点连接过密,或者方向关系异常,往往意味着前面的筛选步骤需要回看。
在ceRNA文章中,网络图通常是核心图之一。但它不是终点。真正有说服力的,是网络图之后还能接出富集分析、生存分析和验证实验。
4. 提高ceRNA文章质量的关键细节
4.1 不是所有候选分子都值得进入网络
很多初学者会犯一个错误,觉得候选越多越好。其实不然。ceRNA网络越大,解释成本越高,噪音也越大。
更合理的做法,是通过多轮过滤保留最核心的节点。
你可以按以下顺序压缩网络:
- 差异表达过滤。
- 数据库交集过滤。
- 证据等级过滤。
- 相关性过滤。
- 临床相关性过滤。
这套逻辑适合多数文章。最终留下的往往不是最多的节点,而是最容易讲清楚的节点。
4.2 多组学和外部验证能明显提升可信度
如果条件允许,建议加入以下至少一种验证:
- 外部数据集验证。
- 生存分析验证。
- qPCR验证。
- 双荧光素酶报告验证。
- 免疫组化或组织水平验证。
验证越多,网络越接近真实生物学机制。
这也是高水平ceRNA文章最常见的特征之一。
从科研训练角度看,ceRNA研究非常适合训练“数据整合能力”。因为它要求你同时理解表达数据、数据库证据、统计学阈值和生物学解释。对医学生、医生和科研人员来说,这类训练非常有价值。
4.3 常见误区要提前避免
做ceRNA分析时,常见问题包括:
- 只做预测,不做验证。
- 只画网络,不做方向判断。
- 阈值设置前后不一致。
- 图很多,但主线不清晰。
- 结果只停留在相关性,没有机制闭环。
如果你的文章只能证明“有关联”,却不能说明“为什么有关联”,那它离高质量研究还差一步。
5. 从方法到落地,解螺旋如何帮助你更快完成分析
如果你已经能理解ceRNA框架,下一步就是把它变成可执行的分析流程。对于很多研究者来说,真正的难点不是概念,而是工具、代码和文章结构的衔接。这也是解螺旋能解决的问题。
解螺旋可以帮助你把ceRNA分析中的关键环节拆开,包括数据预处理、差异分析、靶基因筛选、相关性计算、网络绘制和结果整理。你不需要从零反复试错,而是可以基于成熟流程快速推进,减少重复劳动,把时间留给真正重要的科研判断。
总结Conclusion
ceRNA网络生物信息学分析的核心,不是“会不会画网络图”,而是能否把差异分析、数据库证据、相关性验证和可视化整合成一条严谨证据链。先搭框架,再做筛选,最后验证,是从零入门到独立完成研究的关键路径。
如果你正在准备课题、论文或标书,建议你先按本文的逻辑梳理一遍自己的数据和问题。需要更高效地完成分析流程时,也可以借助解螺旋 ,让生信ceRNA网络分析更快落地,更稳地走向可发表结果。

- 引言Introduction
- 1. 先理解ceRNA分析的底层逻辑
- 2. 从文献和数据库开始搭建你的研究框架
- 3. ceRNA网络分析的标准流程
- 4. 提高ceRNA文章质量的关键细节
- 5. 从方法到落地,解螺旋如何帮助你更快完成分析
- 总结Conclusion