23
 分享
引言Introduction
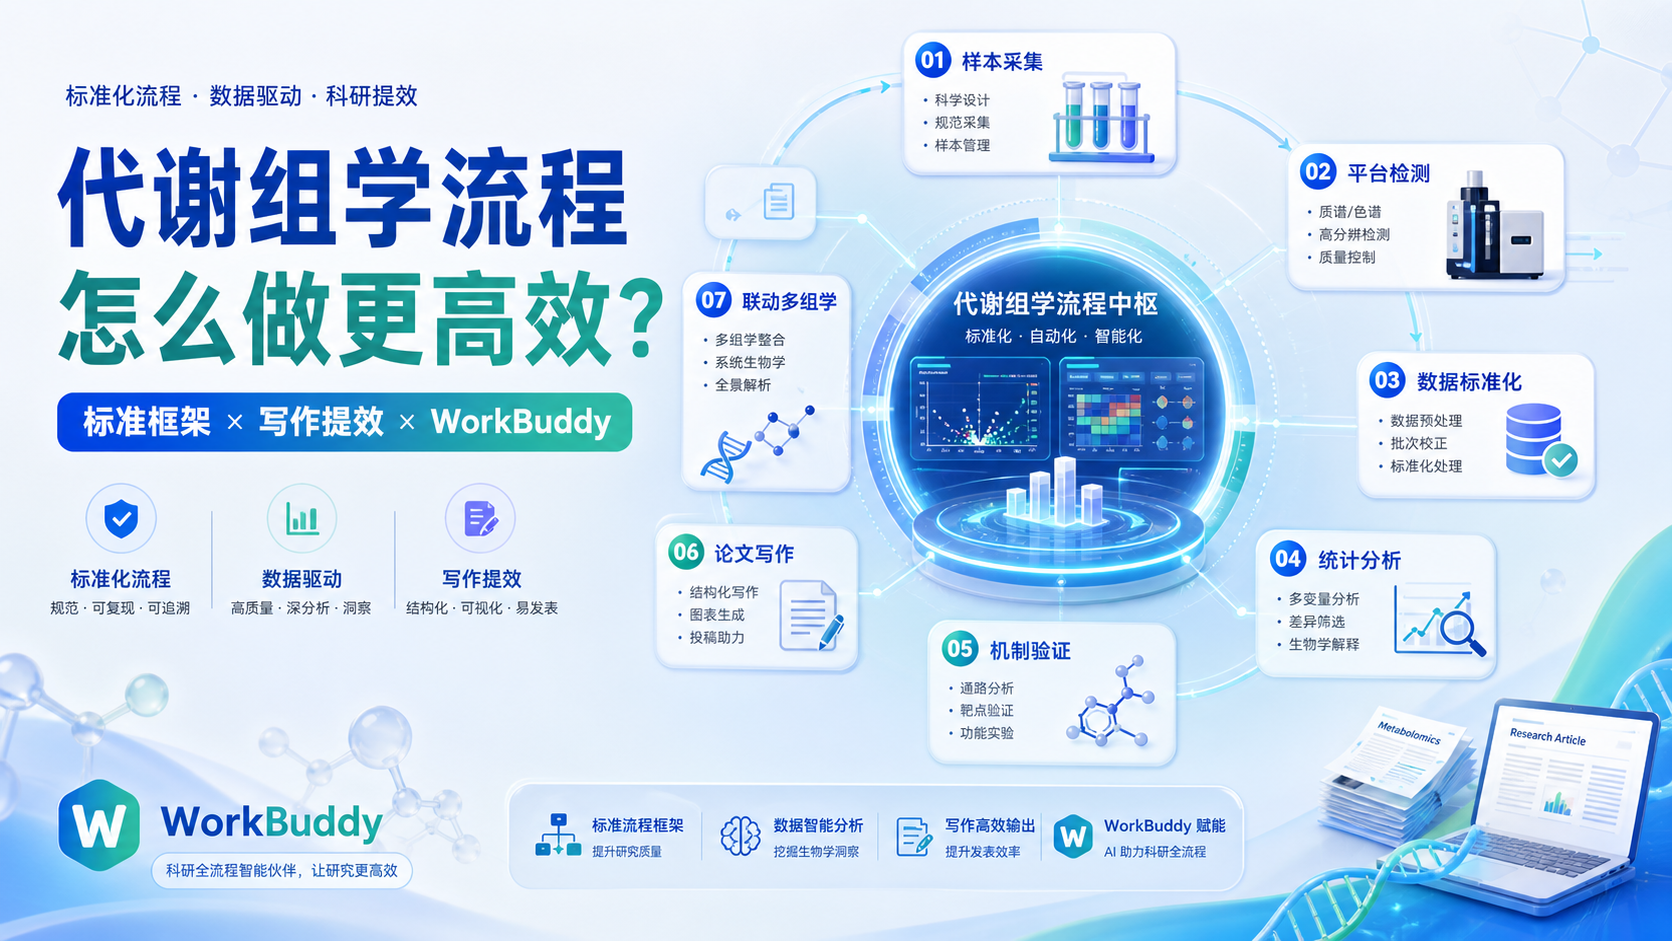
代谢组学流程复杂,常见痛点是样本处理多、数据分析链条长、结果解释难。对医学生、医生和科研人员来说,最耗时的不是“做不做”,而是“怎么做得规范、可复现、能发文”。WorkBuddy代谢组学流程可以把分析套路拆成清晰步骤,减少试错成本。
1. 代谢组学流程为什么难,难在哪里
1.1 代谢组学不是单纯“测一测”
代谢组学研究的是小分子代谢物,包括底物、中间体和代谢产物。它和转录组不同。转录组看的是基因表达,代谢组看的是最终表型层面的化学变化。这意味着代谢组学更接近疾病真实状态,但也更受实验条件影响。
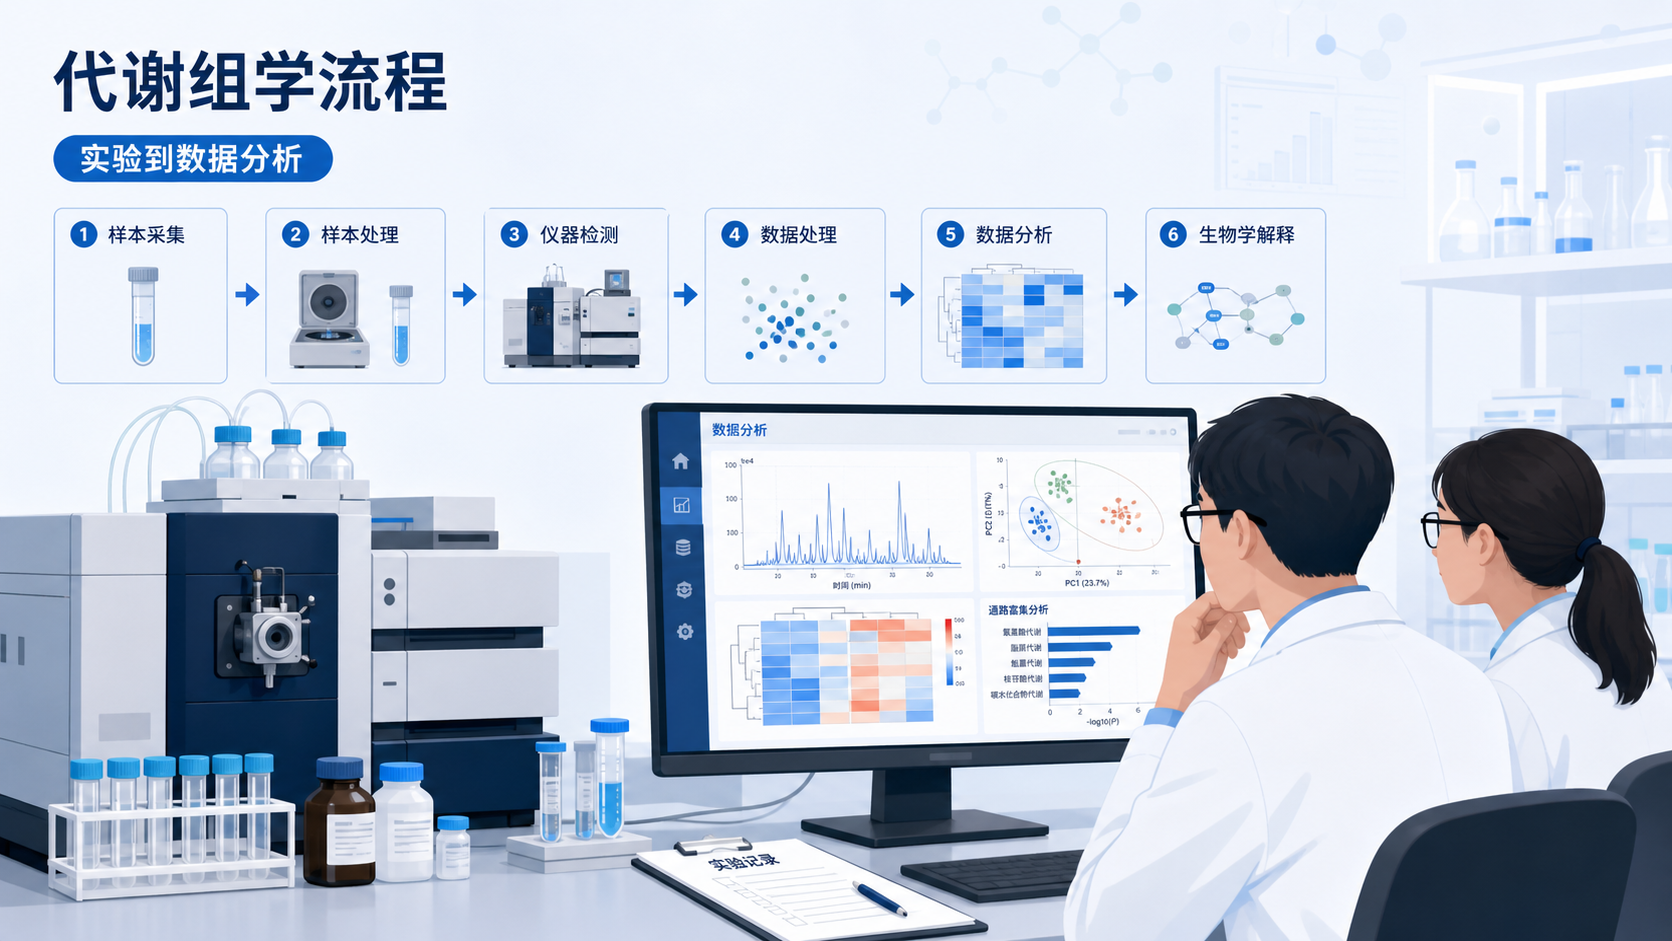
在实际研究中,代谢组流程通常涉及样本采集、前处理、质谱检测、峰识别、代谢物注释、统计分析和通路解释。每一步都可能影响结果。一个前处理批次偏差,就可能让后续差异代谢物筛选失真。
1.2 难点集中在三处
代谢组学最常见的难点有三个。
-
实验设计难。
不是所有课题都适合做代谢组。若研究问题不明确,后面很容易得到一堆“能解释但不够聚焦”的结果。 -
数据处理难。
GC-MS、LC-MS、NMR等平台产生的数据量大,且存在峰对齐、归一化、缺失值处理等问题。 -
结果解释难。
差异代谢物不等于机制。还需要结合通路、临床表型或其他组学,才能形成完整故事线。
所以,代谢组学流程的核心不是“多做一步”,而是把每一步做对。
2. 典型代谢组学流程的标准框架
2.1 从研究问题开始,而不是从数据开始
代谢组学最关键的起点是研究假设。先明确你要回答什么问题,再决定样本类型、检测平台和统计策略。比如,是想找疾病生物标志物,还是想解释药物干预后的代谢变化。
一个较规范的流程通常包括以下阶段。
- 研究设计与分组
- 样本采集与保存
- 代谢物提取与检测
- 数据预处理
- 差异代谢物筛选
- 通路富集与网络解释
- 与表型或其他组学联合分析
如果起点不清晰,后面再精细的数据分析也很难形成高质量论文。
2.2 样本与平台决定下限
代谢组学非常依赖样本质量。血浆、血清、尿液、组织、细胞裂解液,不同样本类型对应不同前处理要求。采样时间、空腹状态、冻融次数、储存温度都会影响代谢谱。
检测平台方面,常见技术包括:
- GC-MS ,适合挥发性或可衍生化代谢物
- LC-MS ,应用最广,覆盖面更大
- NMR ,重复性较好,但灵敏度相对有限
平台没有绝对优劣,关键是与研究目标匹配。
如果目标是筛查更广泛的代谢变化,LC-MS更常见。若更重视稳定性和定量一致性,NMR也有优势。
2.3 数据分析要先标准化,再谈生物学
代谢组学数据分析不是简单做差异分析。通常需要先处理原始信号,再进入生物学解释。基础步骤包括:
- 峰提取与峰对齐
- 缺失值处理
- 批次效应校正
- 归一化与标准化
- 多变量统计分析
- 差异代谢物筛选
常见统计工具包括PCA、PLS-DA、OPLS-DA等。PCA用于整体分布观察,PLS-DA用于分组判别,但必须注意过拟合风险。如果没有严格验证,判别模型很容易“看起来很好”,实际上不稳健。
3. WorkBuddy如何加速代谢组学流程
3.1 把“流程拆解”变成“可执行任务”
很多科研人员卡在代谢组学,不是因为不会看文献,而是因为流程太碎。WorkBuddy的优势在于,它可以把代谢组学套路拆成阶段化任务,帮助你快速梳理研究路径。
例如,围绕一个课题,系统可以帮助你把内容拆成:
- 研究背景与科学问题
- 样本设计与分组逻辑
- 检测平台选择
- 数据分析步骤
- 结果呈现结构
- 讨论部分的机制延伸
这类拆解非常适合做开题、基金和论文初稿。
你不需要从零搭框架,而是先获得一个完整骨架,再进行人工修订。
3.2 从前期文章中提炼分析套路
代谢组学研究很依赖“参考范式”。同一类疾病、同一类干预,往往有类似的分析套路。WorkBuddy可对上传的前期文章进行结构化提炼,帮助你识别:
- 研究对象与分组方式
- 检测平台与参数
- 统计学策略
- 关键差异代谢物
- 主要通路与机制假说
这一步的价值在于,能把“读文献”变成“提炼可复用方法”。
对新手来说,它能减少盲目模仿。对有经验的科研人员来说,它能加快方案迭代。
3.3 让代谢组学和其他组学更容易联动
代谢组学本身很有价值,但和转录组、微生物组、蛋白组联合后,往往更容易形成高水平论文。原因很简单。多组学能从“基因变化”走到“功能变化”,再落到“代谢表型”。
常见联动方式包括:
- 转录组和代谢组联合看通路一致性
- 微生物组和代谢组联合解释肠道轴
- 临床指标和代谢组联合构建预测模型
WorkBuddy的价值不只是生成结果,而是帮助你把单一代谢组结果升级为组合证据链。
这对文章完整性、机制深度和投稿竞争力都很重要。
4. 代谢组学论文中最常见的高质量写法
4.1 先讲现象,再讲机制
高质量代谢组学论文通常遵循一个清晰逻辑。
- 疾病或处理导致代谢谱改变
- 筛出差异代谢物
- 通过富集分析定位核心通路
- 结合临床或实验验证形成机制闭环
这样的写法比单纯罗列代谢物更容易让审稿人接受。因为审稿人看的不是“你测到了多少”,而是“你是否回答了科学问题”。
4.2 验证环节不能省
代谢组学常见问题是“发现多,验证少”。如果只停留在发现层面,文章说服力有限。通常建议至少保留以下一种验证方式:
- 靶向代谢验证
- 独立队列复现
- qPCR或蛋白验证相关通路基因
- 功能实验验证表型
验证不是装饰,而是提高可信度的关键。
对于医学生和临床科研人员,尤其要注意这一点。临床研究更重视重复性和外推性。
4.3 讨论部分要避免过度推断
代谢变化可以提示机制,但不能直接等同因果。写讨论时要区分三层:
- 关联
- 推测
- 验证
把相关性写成因果,是代谢组学论文最常见的失误之一。
更稳妥的方式是结合已有文献、实验结果和路径证据,逐步推进结论。
5. 适合哪些科研场景使用WorkBuddy
5.1 适合开题和基金准备
如果你正处在选题阶段,WorkBuddy可以帮助你快速形成代谢组学研究框架。尤其适合以下场景:
- 课题方向明确,但分析路径不完整
- 有前期文章,想进一步扩展成新课题
- 需要快速整理立项依据和研究设计
- 需要把代谢组学和其他组学整合成更完整方案
它更像科研加速器,而不是替代研究者判断的工具。
5.2 适合论文初稿和投稿前梳理
对于已有实验数据的团队,WorkBuddy可以帮助整理文章结构,快速形成结果叙事。你可以先建立“研究问题—方法—结果—机制”的主线,再根据数据细化图表和统计方法。
对于投稿前的论文,也可以用它检查逻辑是否完整,是否存在流程跳步、结论超前或机制不足的问题。这对提高稿件一致性很有帮助。
总结Conclusion
代谢组学流程的关键,不是单点技术,而是从实验设计到结果解释的完整链条。对医学生、医生和科研人员来说,真正影响产出的,是流程是否清晰、数据是否规范、结论是否站得住。WorkBuddy代谢组学流程的价值,在于把复杂研究拆成可执行步骤,帮助你更快形成可发表、可复现、可延展的科研方案。
如果你正在做代谢组学课题,或准备把代谢组结果写进论文和基金,建议用解螺旋的WorkBuddy先把分析套路理顺,再进入具体实验和写作。这样能少走弯路,也更容易做出有逻辑、有深度的研究。
- 引言Introduction
- 1. 代谢组学流程为什么难,难在哪里
- 2. 典型代谢组学流程的标准框架
- 3. WorkBuddy如何加速代谢组学流程
- 4. 代谢组学论文中最常见的高质量写法
- 5. 适合哪些科研场景使用WorkBuddy
- 总结Conclusion