10
 分享
引言Introduction
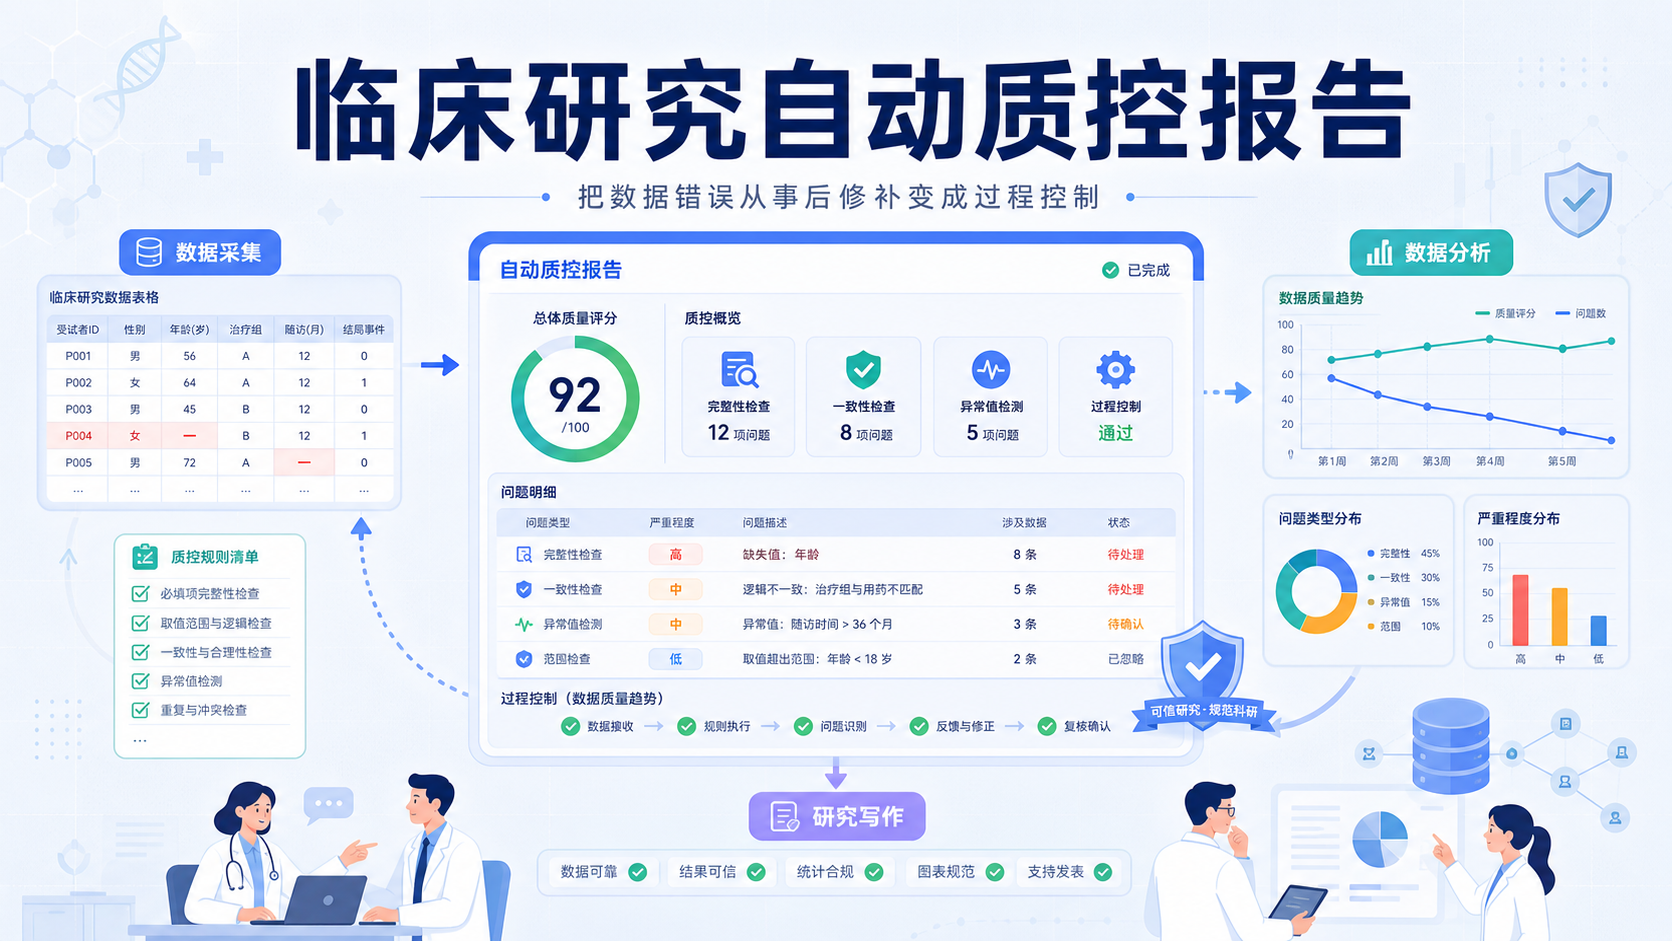
临床研究最怕什么。不是没有数据,而是数据看似完整,实际错误很多。变量缺失、逻辑冲突、随访不一致,都会直接影响统计结果和论文质量。WorkBuddy自动质控报告的价值,就在于把这些隐性问题尽早暴露出来。 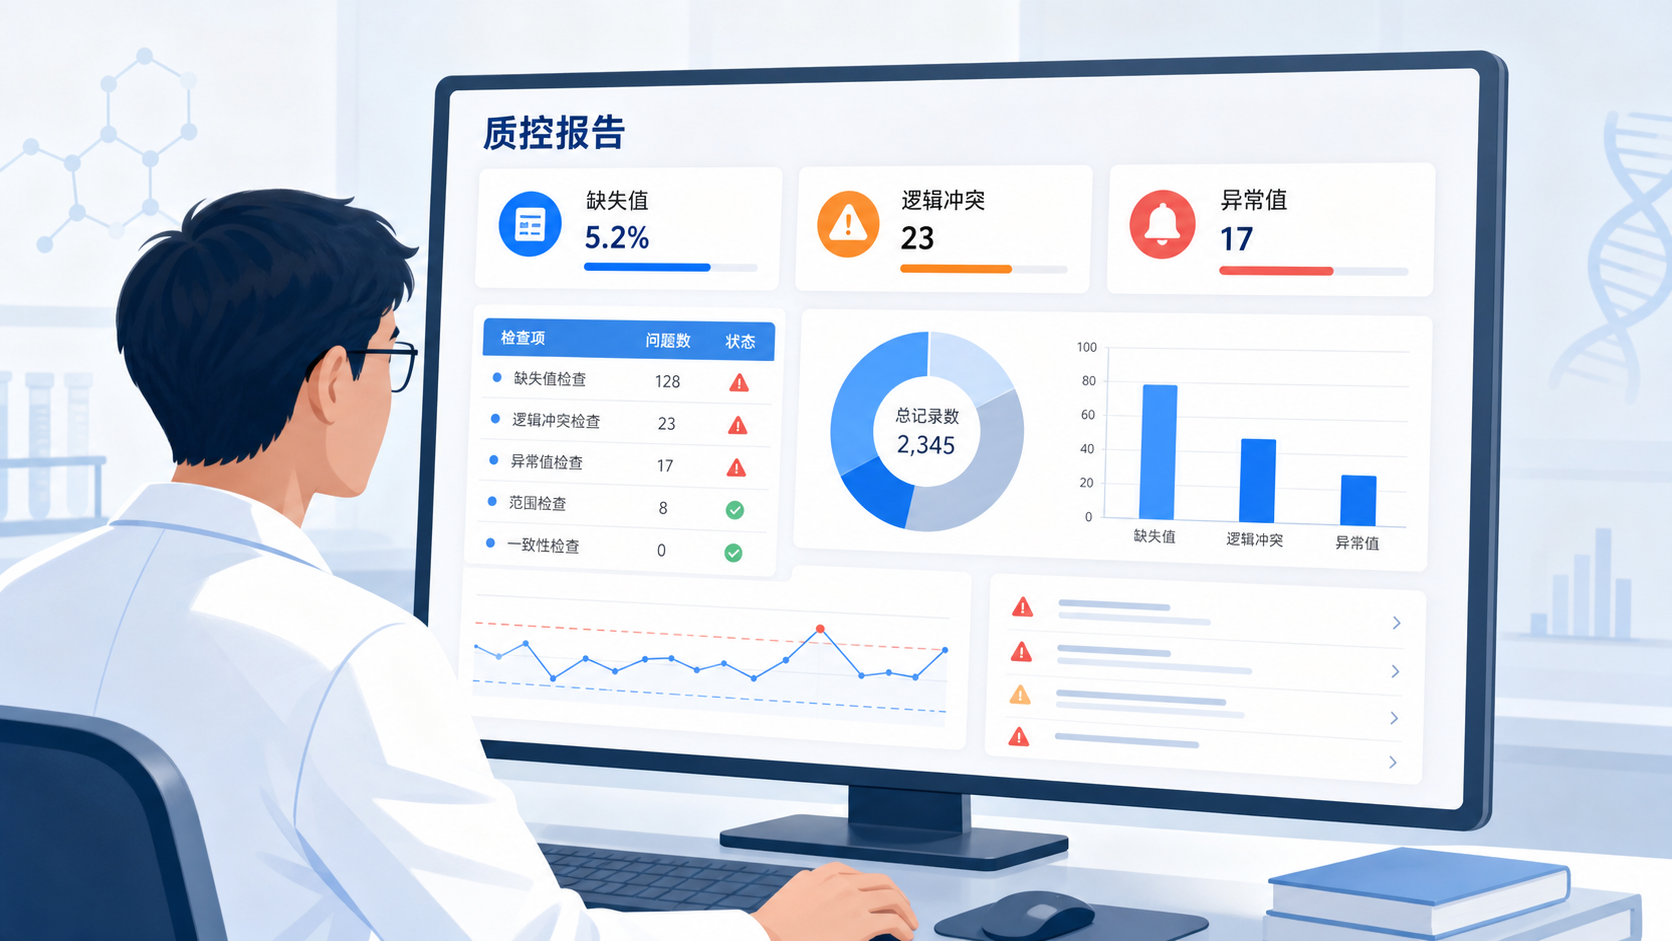
1. 为什么临床研究需要自动质控报告
1.1 数据问题往往不是“有没有”,而是“对不对”
临床研究数据通常来自CRF、病历系统、检验系统和随访记录。来源越多,问题越复杂。常见错误包括:
- 年龄、性别、诊断日期前后矛盾。
- 检查指标单位不统一。
- 同一患者重复录入。
- 基线与随访时间点错位。
- 关键结局变量缺失。
这些问题不会在录入时全部显现,但会在统计分析阶段集中爆发。一旦进入建模和发表环节,返工成本会成倍增加。
1.2 传统人工质控的效率瓶颈很明显
人工质控依赖研究者逐条核对。对于几十例样本还可接受,但当样本量达到100例以上,人工检查就会明显变慢。若变量维度高,问题更多。
临床研究中,100例并不是“很多”,但已经足够暴露数据结构问题。尤其是在队列研究、回顾性分析和临床试验中,变量多、时间点多、结局复杂。人工方式通常只能发现表层错误,难以系统识别逻辑异常。
1.3 自动质控的核心,是把规则前置
自动质控不是替代研究者判断,而是先完成机器可识别的规则检查。比如:
- 缺失值检查。
- 范围检查。
- 逻辑一致性检查。
- 时间顺序检查。
- 重复记录检查。
这类规则一旦固化,后续每批数据都可以快速复用。这比每次从头人工核对更稳定,也更适合标准化科研流程。
2. WorkBuddy自动质控报告能解决什么问题
2.1 把数据错误从“事后修补”变成“过程控制”
WorkBuddy自动质控报告的重点,不是简单出一份表,而是帮助研究者在数据分析前完成质量门控。它适合放在以下环节:
- CRF表录入完成后。
- 数据清洗前。
- 统计分析前。
- 论文撰写前。
这样做的好处很直接。问题越早发现,修正成本越低。 如果等到统计结果出来再回头查数据,很多工作都会重做。
2.2 自动识别高频错误类型
在临床研究中,最常见的质控问题基本集中在几类:
- 空值过多。
- 异常值超出医学合理范围。
- 连续变量分布异常。
- 分类变量编码不一致。
- 同一患者前后字段冲突。
WorkBuddy自动质控报告可以把这些问题结构化呈现。研究者不用翻成百上千行Excel去找问题,而是直接看到问题列表和定位信息。这对医生、科研人员和统计人员都更高效。
2.3 适合临床研究的真实场景,而不是只做“演示数据”
临床研究的数据规范性要求远高于一般文本任务。因为它涉及纳排标准、随访窗口、终点定义和统计口径。一个字段错了,可能就会影响整组样本。
例如:
- 入组日期晚于首次治疗日期。
- 随访终点早于暴露时间。
- 既往史与诊断信息互相冲突。
- 连续变量与单位不一致,导致统计偏移。
WorkBuddy自动质控报告的意义,在于把这些临床逻辑问题尽量提前拦截。
3. 一份高质量自动质控报告应包含哪些内容
3.1 数据完整性检查
完整性是基础。报告至少要看三类信息:
- 总样本量。
- 各变量缺失率。
- 关键字段缺失分布。
如果核心结局变量缺失过高,研究设计本身就可能受影响。对于回顾性研究,缺失不是稀奇事,但必须明确缺失结构。没有完整性评估,就很难判断数据能否进入正式分析。
3.2 数据一致性检查
一致性检查关注的是变量之间是否符合逻辑。常见规则包括:
- 性别与妊娠相关变量是否冲突。
- 诊断时间与治疗时间是否矛盾。
- 出院时间是否早于入院时间。
- 复查结果是否遵循时间顺序。
这类问题单看一个字段不容易发现,必须依赖跨字段规则。自动质控报告的优势,就是可以批量识别这种逻辑冲突。
3.3 异常值与分布检查
异常值不一定都是错误,但一定要解释。比如极端年龄、极端实验室指标、极端随访时间,可能来自录入错误,也可能是真实病例。
一份合格的质控报告应该同时给出:
- 异常值提示。
- 数据分布概况。
- 需要人工复核的字段。
这能帮助研究者把时间花在最关键的问题上,而不是机械重复核对。异常值处理必须保留医学解释,而不是简单删值。
4. 如何把自动质控报告嵌入临床研究流程
4.1 建议采用“采集、质控、分析、写作”四步法
临床研究最稳妥的流程,不是边收数据边写论文,而是先把流程分开。
推荐顺序如下:
- 明确研究问题和变量表。
- 录入或导出数据。
- 运行自动质控报告。
- 根据报告修正数据。
- 再进入统计分析。
- 最后完成论文写作。
只要质控前置,后续统计效率会明显提高。
4.2 重点盯住三个节点
临床研究中,最容易出问题的节点通常是:
- 数据录入完成时。
- 变量合并完成时。
- 统计前最终定稿时。
这三个节点如果能各做一次自动质控,很多低级错误都能避免。尤其是多中心研究和长随访研究,数据源多,版本多,必须依赖规则化质控。
4.3 把质控结果和统计需求对应起来
质控报告不是孤立文件。它应该直接服务统计分析。比如:
- 缺失率高的变量,是否需要剔除。
- 异常值是否需要截尾或敏感性分析。
- 编码不一致的分类变量,是否需要重新归类。
- 时间字段冲突,是否影响生存分析。
能直接进入统计决策的质控报告,才是真正有用的报告。
5. WorkBuddy自动质控报告对医学生和科研人员的实际价值
5.1 减少重复劳动
很多科研时间并不是花在“分析”上,而是花在找错、改错、再核对上。自动质控能把这部分重复劳动压缩掉,让研究者更快进入高价值环节。
对医学生来说,这意味着更快学会研究流程。对临床医生来说,这意味着在有限时间内完成更规范的数据整理。对科研人员来说,这意味着更快形成可发表的数据底稿。效率提升的本质,是减少低水平返工。
5.2 提高研究可信度
科研质量不只看结果,更看过程。数据质量差,再漂亮的图表也站不住。自动质控报告可以帮助研究团队建立更稳定的科研标准,减少人为遗漏。
在论文审稿和课题答辩中,数据清洗逻辑是否清楚,往往直接影响可信度。一份结构清晰的质控报告,本身就是研究规范性的证明。
5.3 让小团队也能做规范化研究
不是每个课题组都有专职数据管理员或统计师。小团队最缺的,往往不是想法,而是规范工具。自动质控报告可以把复杂流程标准化,降低门槛。
这对单中心回顾性研究、博士课题、青年基金预实验都很有意义。当工具足够标准化,研究质量就不再完全依赖个人经验。
6. 如何理解“零差错方案”的边界
6.1 零差错不是绝对无误,而是把错误控制在可管理范围
临床研究中,“零差错”更多是一种管理目标,而不是数学意义上的绝对零误差。真正可行的做法,是通过规则检查,把错误尽可能前移、尽可能减少、尽可能可追溯。
这意味着三点:
- 错误可被发现。
- 错误可被定位。
- 错误可被修正并留痕。
真正专业的质控,不是声称没有问题,而是能系统发现问题。
6.2 自动化与人工复核要结合
再好的系统也不能替代临床判断。自动质控擅长规则化识别,但最终仍需要研究者判断医学合理性。尤其是涉及特殊病例、罕见病、极端值时,人工复核不可或缺。
因此,最优方案不是“全自动”或“全人工”,而是:
- 自动筛查。
- 人工复核。
- 结果回写。
- 再次确认。
这才是适合临床研究的闭环。
6.3 工具的价值在于稳定复制
如果一个课题组每次都靠个人经验做质控,质量很难稳定。相反,若能把规则固化到工具中,数据管理就会更一致。对于持续产出的团队,这一点尤其重要。
在这个意义上,WorkBuddy自动质控报告的核心价值,不只是“快”,而是“标准化”。它让临床研究的数据质量变成可复制流程。
总结Conclusion
临床研究的数据问题,往往不是单个错误,而是多个小错误叠加。缺失、冲突、异常值、重复录入,任何一个环节失控,都会影响最终结论。WorkBuddy自动质控报告的作用,就是把这些问题前置、可视化、结构化。
对于医学生、医生和科研人员来说,最需要的不是更多手工核对,而是更可靠的流程工具。如果你希望把临床研究从“反复返工”变成“规范推进”,可以借助解螺旋的工作台思路,把自动质控、数据清洗和分析流程整合起来。 这样,研究效率会更高,数据质量也会更稳。
- 引言Introduction
- 1. 为什么临床研究需要自动质控报告
- 2. WorkBuddy自动质控报告能解决什么问题
- 3. 一份高质量自动质控报告应包含哪些内容
- 4. 如何把自动质控报告嵌入临床研究流程
- 5. WorkBuddy自动质控报告对医学生和科研人员的实际价值
- 6. 如何理解“零差错方案”的边界
- 总结Conclusion